第2回に引き続き、Splunk .conf26のProduct Keynote「The Platform for Your Agentic Enterprise」を紹介します。
第1回はこちら
前回は「Trust AI at Scale」を実現する3つのテーマのうち、
・Optimize AI at scale
・Defend at machine speed
の2つを紹介しました。
今回は最後のテーマとなる、
「Turn machine data into agentic action」
について紹介します。
前回まではAI Agentを「どう信頼し、どう制御するのか」という話が中心でしたが、今回はそのAI Agentが判断や行動を行うために必要となる「データ」がテーマとなります。
④Turn machine data into agentic action
AIのモデルには推論能力があり、GPUには処理能力があります。
一方で、企業のシステムでAI Agentが適切に判断するためには、「自社のシステムで今何が起きているのか」というOperational Context(運用上のコンテキスト)が必要になります。
そのコンテキストが存在するのが、Logs/Metrics/TracesなどのMachine Dataです。
そこでSplunkでは、Machine DataをAI Agentや人間が利用できるコンテキストやインテリジェンス(知見)へ変換するためのアーキテクチャとして「Cisco Data Fabric」がSplunkのMangesh Pimpalkhare氏により紹介されました。
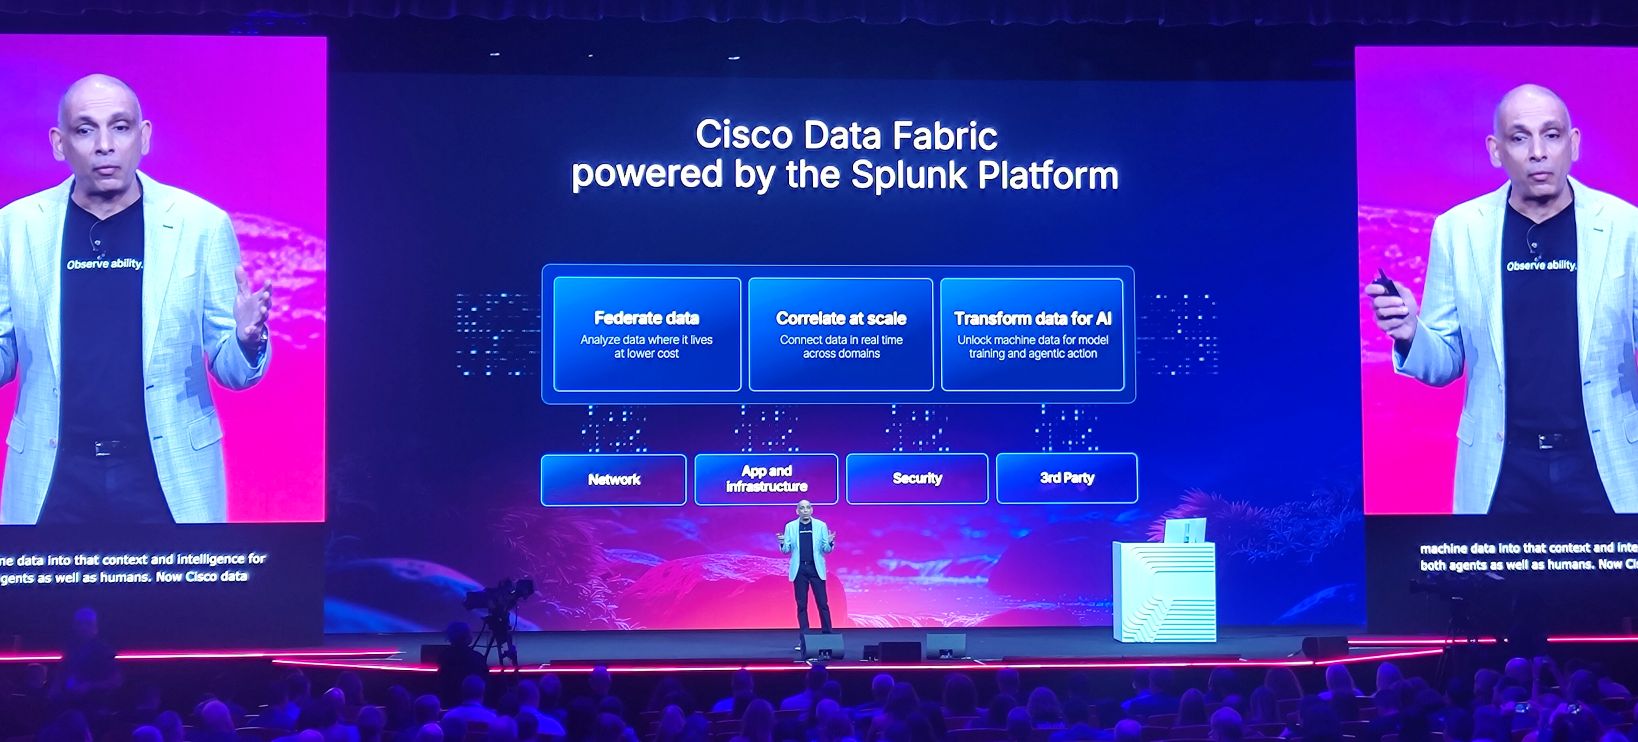
Cisco Data Fabric
Cisco Data Fabricは、企業内のさまざまな場所に存在するデータを横断的に活用し、AI Agentや人間が判断・行動するために必要なコンテキストへ変換する仕組みです。
単一の新製品ではなく、Splunk Platformを中心に、Federated SearchやMachine Data Lake、AIなどの機能を組み合わせて実現します。
Agentic AIの普及によって、AI Agent自身が大量のテレメトリを生成する一方、Agentが正しい判断をするためには企業内に存在するさまざまなデータへアクセスする必要があります。
Cisco Data Fabricでは、
・大量のデータをコストを抑えて扱う
・複数のデータを横断してコンテキストを作る
・そのコンテキストをAI Agentや人間のAction(行動)につなげる
という流れを実現していきます。
Cisco Data Fabricは既存のSplunk Platformを基盤としており、現在利用しているSplunk Platformも今後進化していくため、新しいPlatformへ買い替える必要はないと説明されていました。
Asurionとの対談
続いてAsurionとの対談が行われました。
AsurionではAgentic SOCやSplunk AI Assistant、MCPなどを活用しながら、AI Agentの利用範囲を広げています。
AIを急いで導入するのではなく、まずデータやインフラといった基盤を整えることが重要という話でした。
AI Agentについても最初からすべてを任せるのではなく、実績を確認しながら徐々に任せる範囲を広げる「Trust but Verify」の考え方が紹介されました。
第2回でもHuman in the Loopが繰り返し登場しましたが、ここでも同じ考え方が示されています。
大量のデータをどう扱うのか
AI時代には、AI Agent自身も大量のテレメトリを生成します。
一方で、すべてのデータを常に高コストな領域へ保存しておく必要があるとは限りません。
そこで紹介されたのが、
・AI-Powered Data Management
・Machine Data Lake
・Federated Search
です。
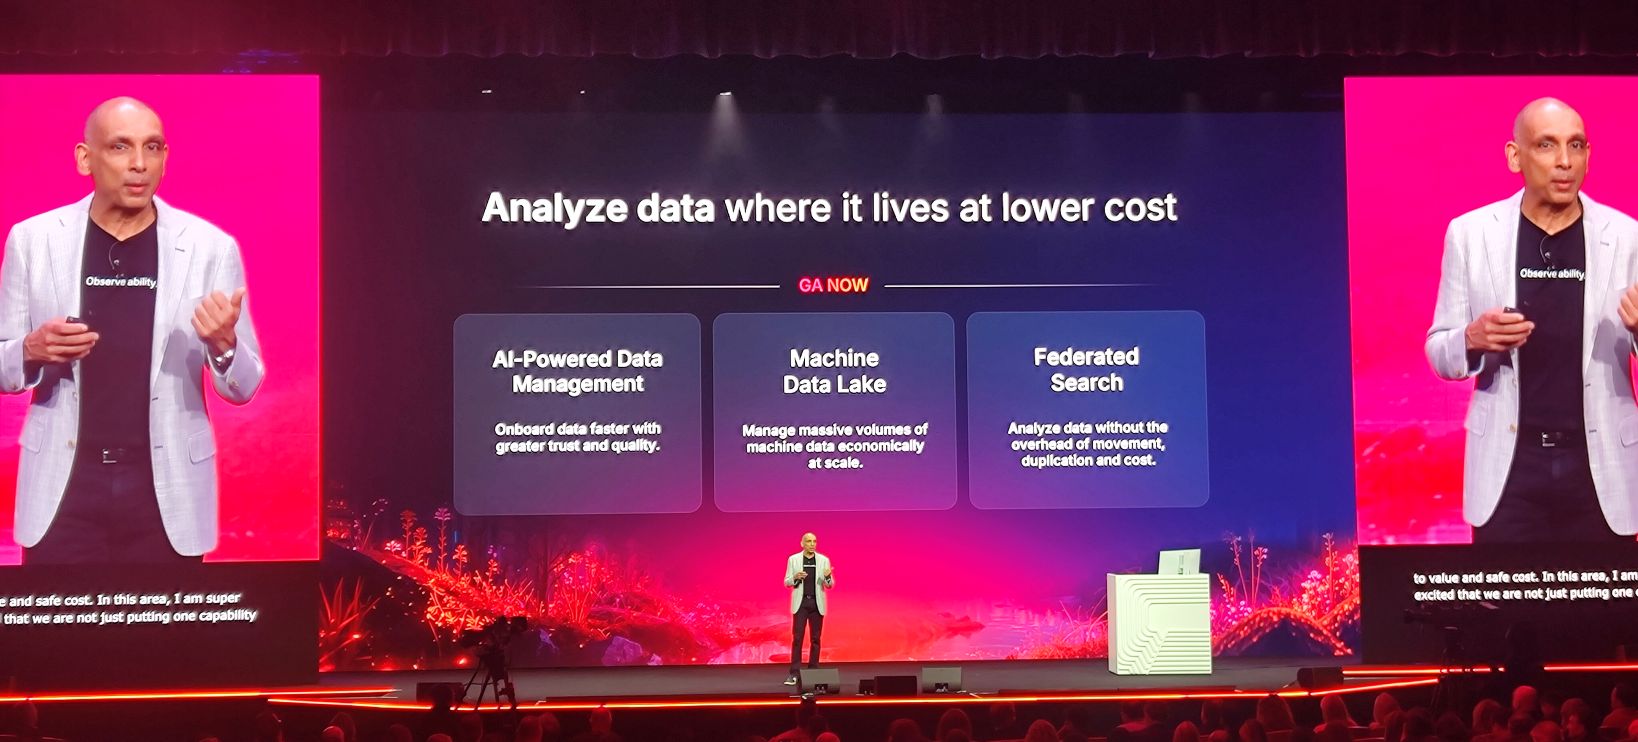
これらの機能はすべてGA済みのアナウンスがありました。
・AI-Powered Data Management
新しいデータの取り込みやデータ形式の整理、データを取り込む処理の自動修復などをAIが支援し、管理者の運用負荷を軽減します。
・Machine Data Lake
すぐに利用しないデータを低コストなストレージへ保存し、AIによる分析や調査で必要になった際に利用できるようにします。
・Federated Search
データをSplunkへ移動させることなく、データが存在する場所に対して検索を行います。
Federated Searchについては対応先の拡張も紹介され、AWS CloudWatchやDatabricksへの対応が発表されました。
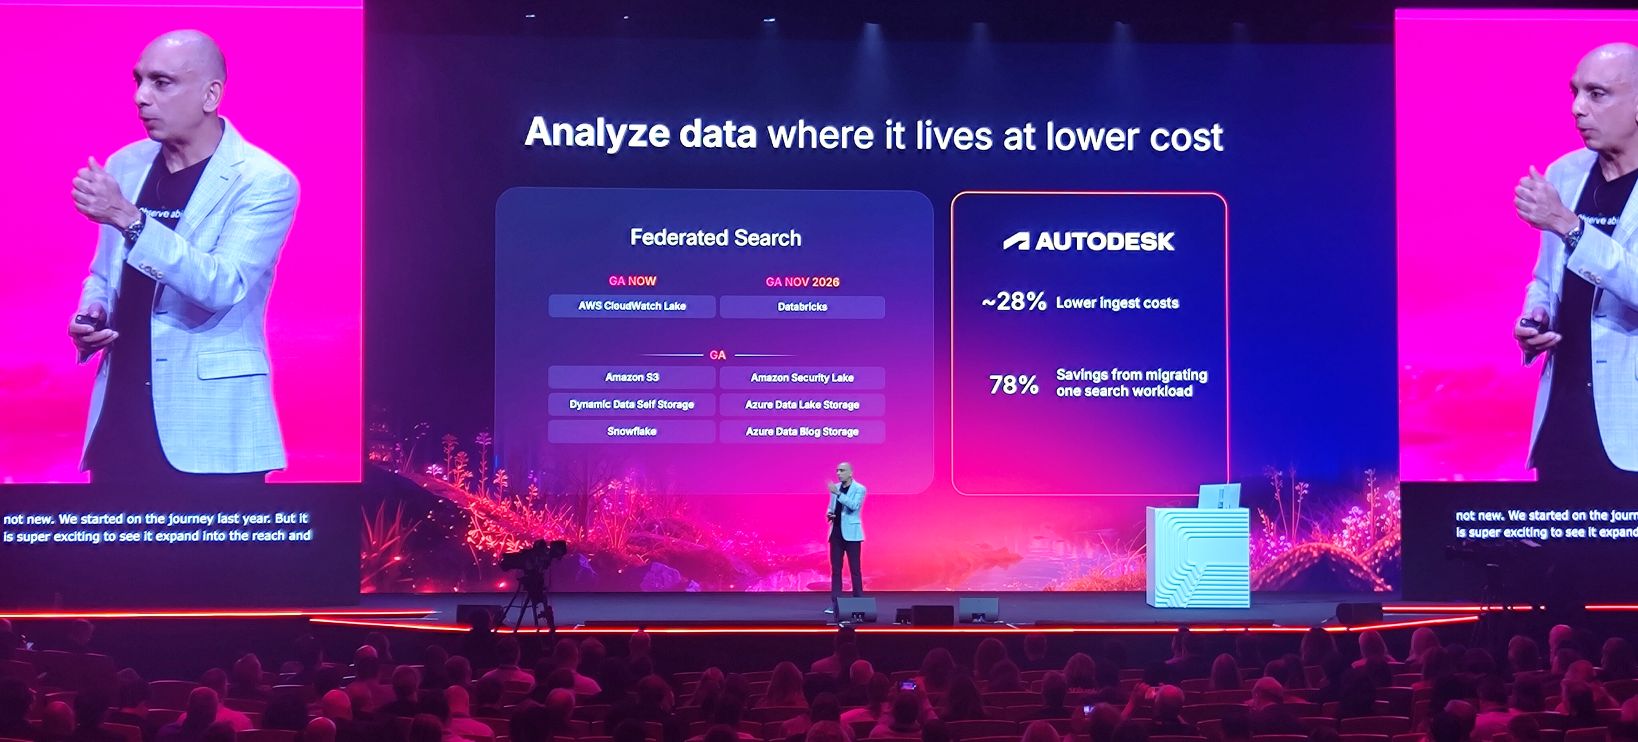
つまりこれらの機能は、「すべてのデータをSplunkに取り込んでから利用する」のではなく、データの価値や利用頻度に応じて適切な場所に保持しながら活用するという方向性です。
Machine Dataをリアルタイムに活用
リアルタイムにデータを活用する機能として、「Universal Collector」「Ingest Processor」「Foundation Models」も紹介されました。
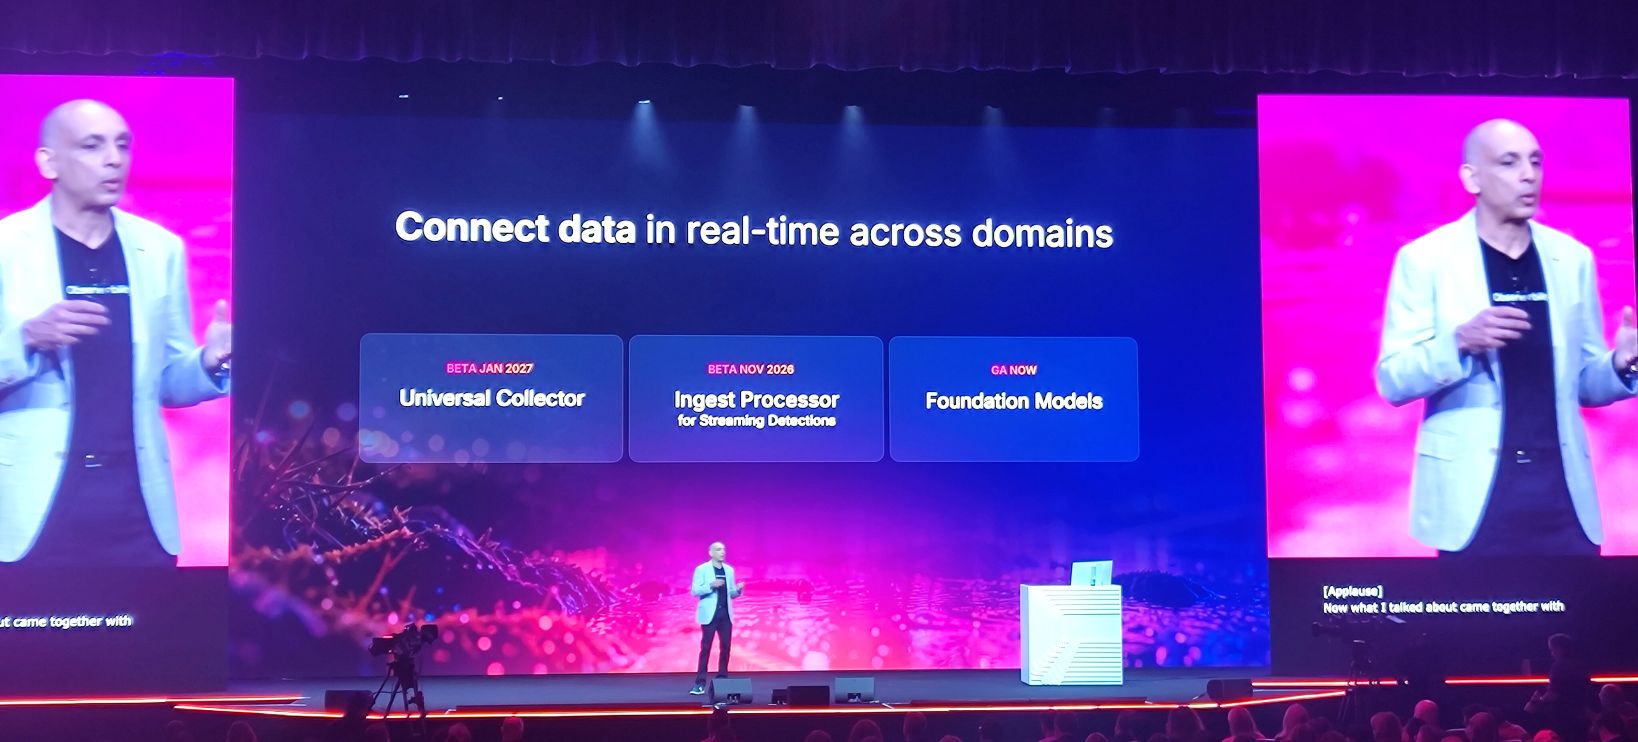
Universal CollectorはOpenTelemetryをベースにテレメトリを収集し、Ingest Processorではデータの取り込み途中でSPL2によるDetectionを実行します。また、Foundation ModelsではMachine Dataからシグナルを抽出・関連付けし、迅速なActionにつなげます。
なお、Universal Collectorは2027年1月にBeta、Ingest Processorは2026年11月にBeta予定で、Foundation ModelsはGA済みと説明されていました。
Machine DataをAgentic Actionへつなげる
ここから話は、データをAI AgentのAction(行動)へつなげる部分へ移ります。
Machine DataをAIのモデルトレーニングやAgentic Actionに活用するため、3つの機能・ソリューションが紹介されました。
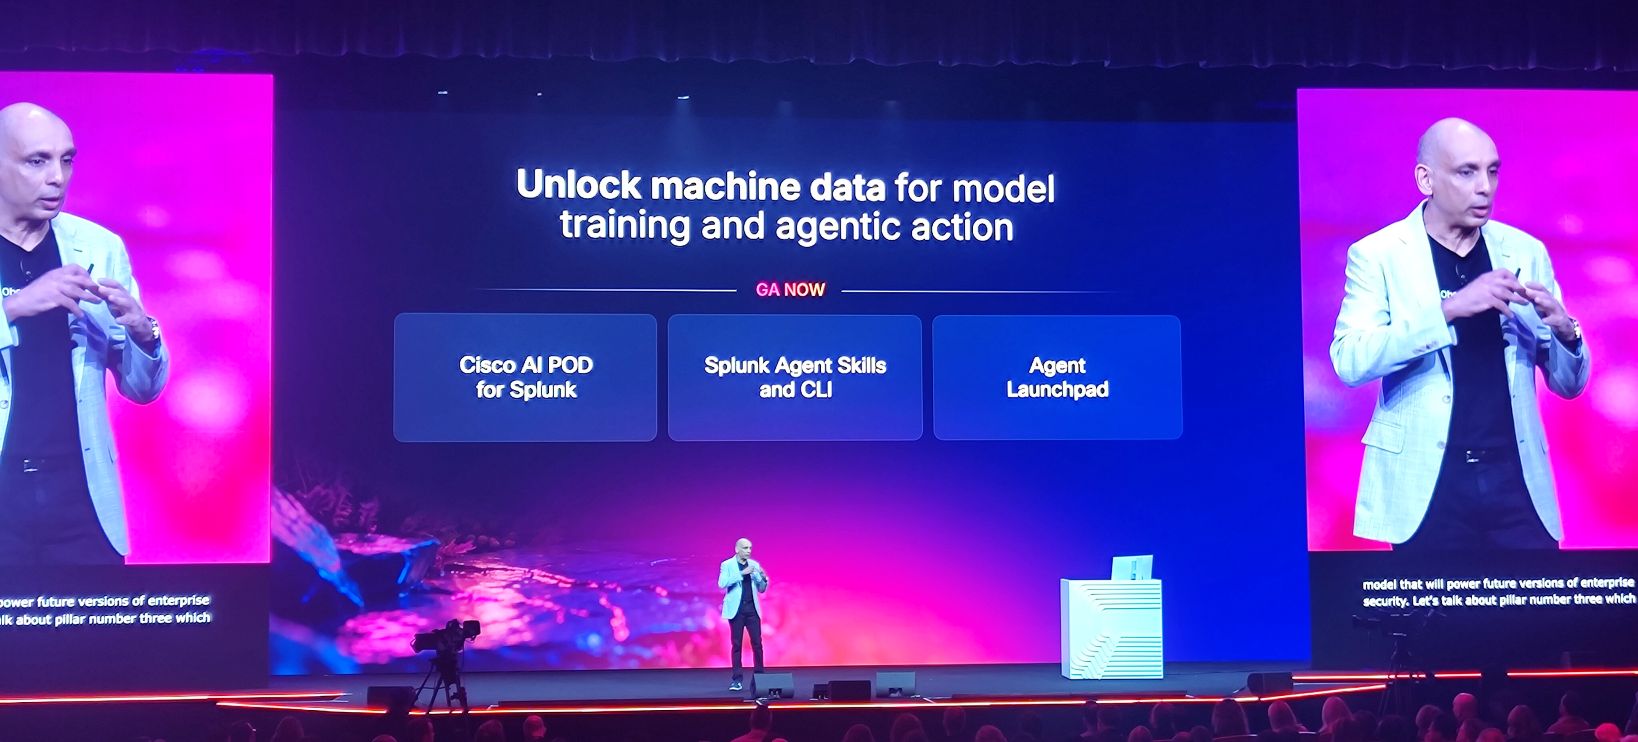
Cisco AI POD for Splunkは、SplunkのAI機能をオンプレミス環境で利用するための仕組みです。
Cisco UCSとNVIDIA GPUを基盤としたCiscoのAI POD上に、SplunkのAI ServiceやModel Runtime、Workload Managementを提供する「AI Tier」を組み合わせた構成となっています。
Splunk Agent Skills and CLIでは、ClaudeやCodexなど外部のAgentic WorkflowからSplunkの機能を利用できます。
Agent Launchpadでは、Splunk上でAI Agentを作成し、さまざまな業務をAgentに実行させることができます。
Agentの名前、実行させたい内容、利用するAI Modelなどを指定することでAgentを作成できます。
Agent Launchpadはすでに利用可能で、Splunkが提供するModelだけではなく、外部のModelを利用することもできます。
さらにMCPを利用することで、SplunkのDataだけではなく、ConfluenceやGitHubなど外部のサービスとも連携し、AI Agentが情報を取得するだけではなくActionまで実行できるようになります。
Cisco Data FabricとAgent Launchpadのライブデモ
SplunkのSonal Pardeshi氏によるCisco Data FabricとAgent Launchpadライブデモが行われました。
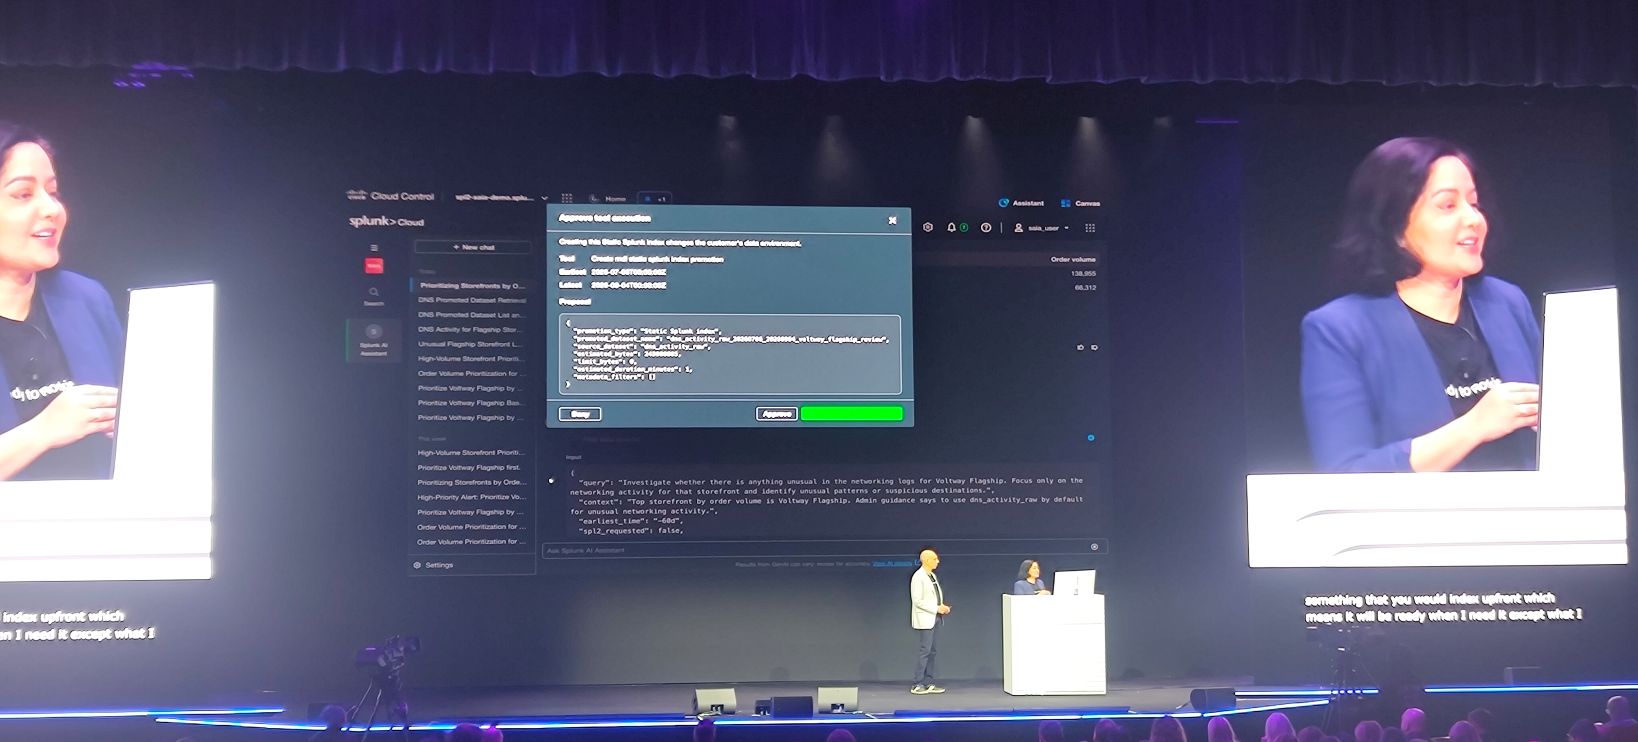
まずCisco Data Fabricのデモとして、AI Assistantを使って優先度の高いアラートが複数店舗で発生している中で、注文量が多くビジネスインパクトの大きい店舗を優先的に調査します。
Operational DataはSplunk上にありますが、注文量などのBusiness DataはSnowflakeに保存されている状況です。
ここでFederated Searchを利用することで、Snowflake側のデータを移動させることなくSplunkのデータと組み合わせて分析し、最も影響の大きい店舗を特定していました。
さらにMachine Data Lakeから調査に必要な店舗・時間帯のDNSデータだけを取り出し、悪性ドメインへの通信があったことを確認していました。
そしてAgent Launchpadのデモでは、100件近く残っていた未処理のアラートについてはAgent Launchpadで作成したAgentがトリアージを実施していました。
デモではAgentがSplunkだけではなく、MCPを通してConfluenceやGitHubなどとも連携し、調査結果からTicketやDocumentを作成するところまで自動化していました。
さらにMCPのAction例として、なぜかステージ上に用意されたコーヒーメーカーまでAI Agentから操作し、実際にコーヒーを淹れるデモも行われました。
Value Insights
最後に、Splunkをより効率的に利用するための「Value Insights」も紹介されました。
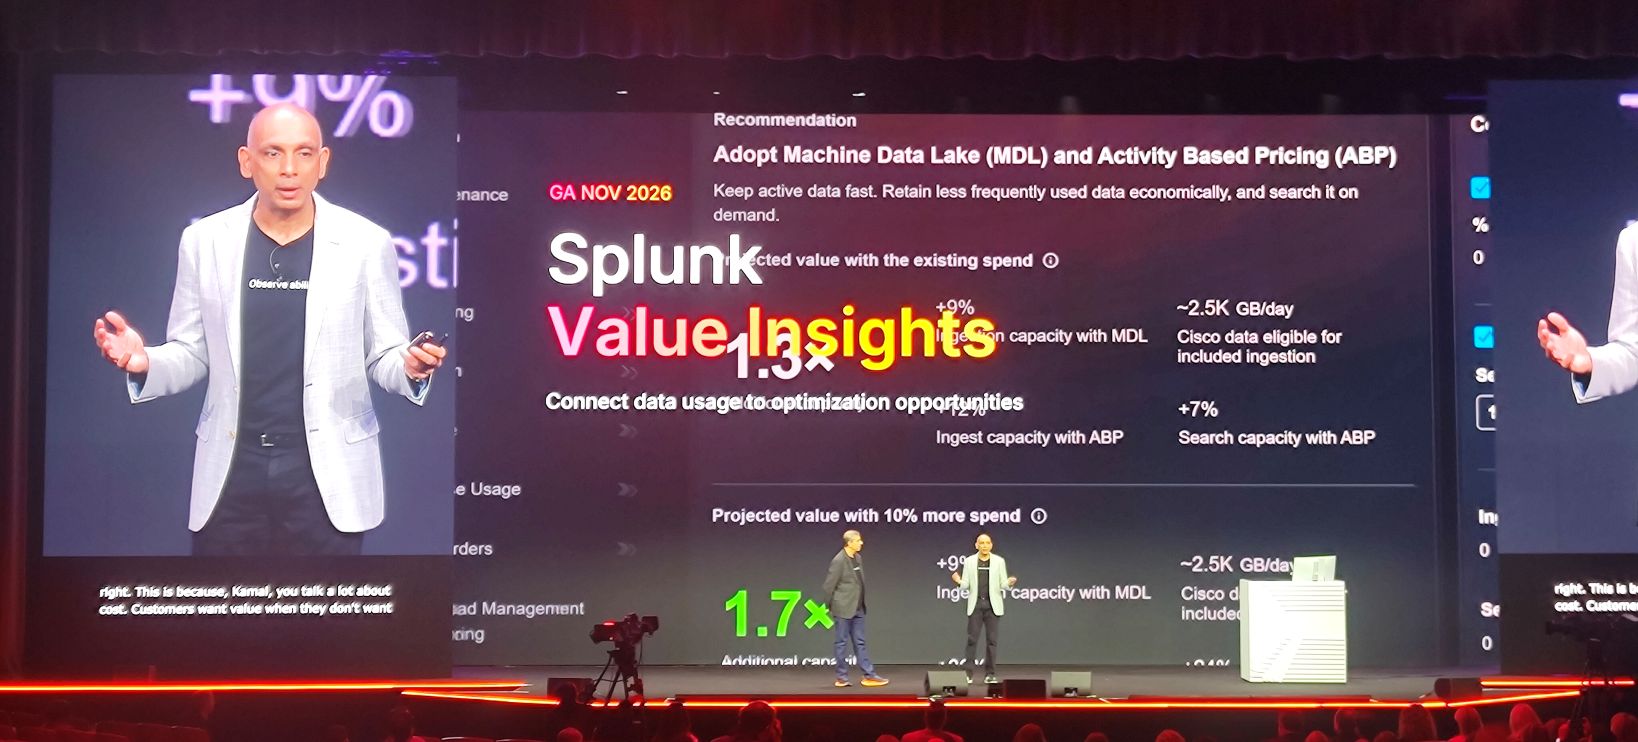
こちらは11月のGA予定です。
Value Insightsでは実際のデータの利用状況を分析し、
「ほとんど検索されていないデータをMachine Data Lakeへ移動すれば、追加費用なしで利用可能な容量を増やせる」
といったリコメンドを提示します。
デモでは、利用頻度の低いデータをMachine Data Lakeへ移動することでSplunkの容量に余裕を作り、検知や分析など、より重要な用途に活用する例が紹介されました。
単純にデータ量を減らすのではなく、データの価値に応じて保存場所やコストを最適化するという考え方です。
まとめ
今回のProduct Keynoteを2回に分けて紹介してきました。
第2回では、AI Agentを安全に利用するためのAgent ObservabilityやAgentic SOCを紹介しました。
そして今回の第3回では、そのAI Agentが判断・行動するためのコンテキストとしてMachine Dataを活用し、それをActionにつなげるCisco Data FabricやAgent Launchpadが紹介されました。
これまでSplunkは「Machine Dataを収集・検索・分析するPlatform」というイメージが強い製品でしたが、今回の発表を見ると、そのデータをAI Agentが利用するコンテキストへ変換し、さらにAgentのActionにつなげるPlatformへと進化しようとしていることが分かります。
今回の.conf26全体を通して感じたのは、単純にSplunkへAI機能を追加するのではなく、Agentic AI時代を前提としてSplunkそのものを「Reimagined」しようとしている点です。
「Trust AI at Scale」を実現するために、
・AI Agentを観測する
・AIを使ってマシンスピードで防御する
・Machine DataをAI AgentのActionへつなげる
という3つを一つのPlatformで実現しようとしていることが、今回のProduct Keynoteの大きなメッセージだったと感じました。
次回の.confはシカゴだそうです!
3回にわたってお届けした.conf26のレポートは最終回となります。
最後までお読みいただきありがとうございました。
他のおすすめ記事はこちら
著者紹介
SB C&S株式会社
技術本部 第2技術統括部 第1技術部 1課
藤ノ木 俊