はじめに
こんにちは。SB C&Sの佐藤です。
AIによるアプリケーション開発は目覚ましい勢いで進化しています。
しかし今日時点では、AIに開発作業を任せるとき「何をやってほしいか」を決めるのは基本的に人間です。
例えば「この機能を追加してほしい」「この不具合を直してほしい」といったタスクを渡し、AIが調査、実装、テスト、Pull Request作成まで進める、というのが分かりやすい使い方です。
一方、実際の開発では「何を直せばよいのか」が最初から分かっているとは限りません。
例えば、リポジトリ全体を見てパフォーマンス上の問題を探したい、使われていないコードを整理したい、テストが不足している箇所を洗い出したい、といったケースです。こうした作業では、修正そのものよりも「どこに問題があるのかを探す」ことに時間がかかることが多いです。
そんな中、2026年9月16日にCognitionから正式に紹介された「Code Scans」は、このようなコードベース全体の調査をDevinに任せるための機能です。
今回は実際にCode Scansを使い、コードのクリーンアップを試してみました。操作方法だけでなく、使ってみて便利だったところや気になったところも含めて紹介します!
目次
Code Scansとは
Code Scansでは、リポジトリ全体を特定の観点から調査できます。
用意されている用途は幅広く、Performance、Database queries、Test coverage、Dead code、Code quality、Cleanup、Telemetry、Accessibility、Compliance、Migration planningなどがあります。さらに、あらかじめ用意された観点に限らず、独自の条件を指定して調査すること(Custom)もできます。
例えばDatabase queriesであれば、N+1クエリや不要なデータベースアクセス、無制限の読み込みといった問題をリポジトリから探すことが可能です。またCleanupでは、不要な抽象化や冗長なコードなど、動作を変えずに整理できる部分を調査します。
ポイントは、単に「リポジトリ全体をAIに読ませる」という仕組みではないという点です。
Code Scansの内部では、Security Swarmのために開発された「Agentic MapReduce」という仕組みが使われています。
Agentic MapReduceを簡単に説明すると、「Devinが調査対象を決めるルールを作り、それをコードベースに適用して対象を分割、その後、複数のDevinがそれぞれを並列で調査し、最後に結果を統合して優先順位を付ける」という仕組みです。
つまり、大きなコードベースを1つの長大なコンテキストに詰め込むのではなく、調査対象を絞って分割しながら処理する設計です。
Security Swarmで使われていた仕組みをセキュリティ以外のコード品質や性能、マイグレーション準備などにも広げたうちの一つがCode Scansである、と考えると分かりやすいと思います。
実際にCode Scansを使ってみる
/scanから始める
Code Scansを始める方法はシンプルです。
Devin Cloudの入力欄で「/scan」と入力すると、実行できるScanの候補が表示されます。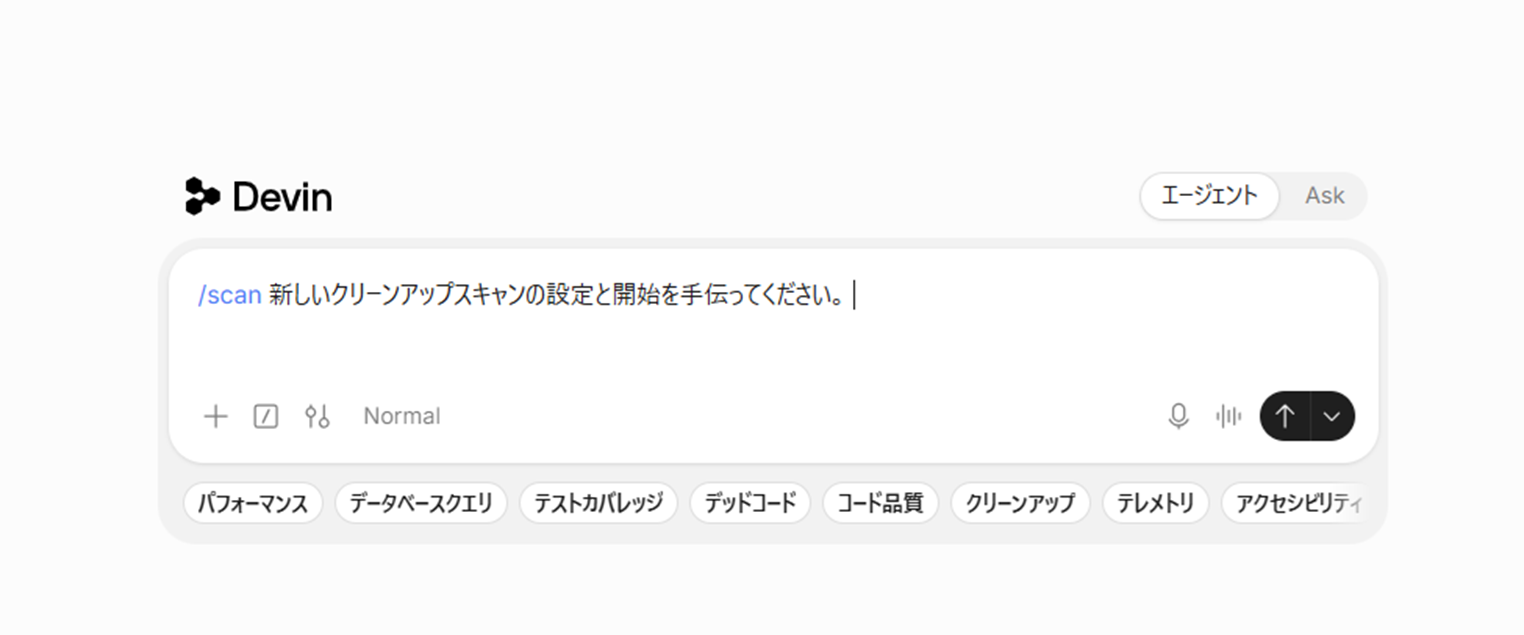
個人的にはこの時点ですでに使いやすさを感じました!
というのも、新しい機能を使う際、「何ができるのか」と「どう指示すればよいのか」が分からず、まずドキュメントを調べるところから始まることがあると思います。
Code Scansでは、/scanを入力すればPerformanceやDatabase query、Test coverage、Dead code、Cleanupなどの候補(※)が表示されるため、機能を触りながら用途を理解できます。
(※)環境設定で表示言語を日本語にしているため、添付画像の候補も日本語で表示されています
今回はコードの整理を試すため、Cleanupを選択しました。
リポジトリと調査範囲を指定する
Scanを選択すると、次に対象リポジトリと、追加でフォーカスする内容を指定します。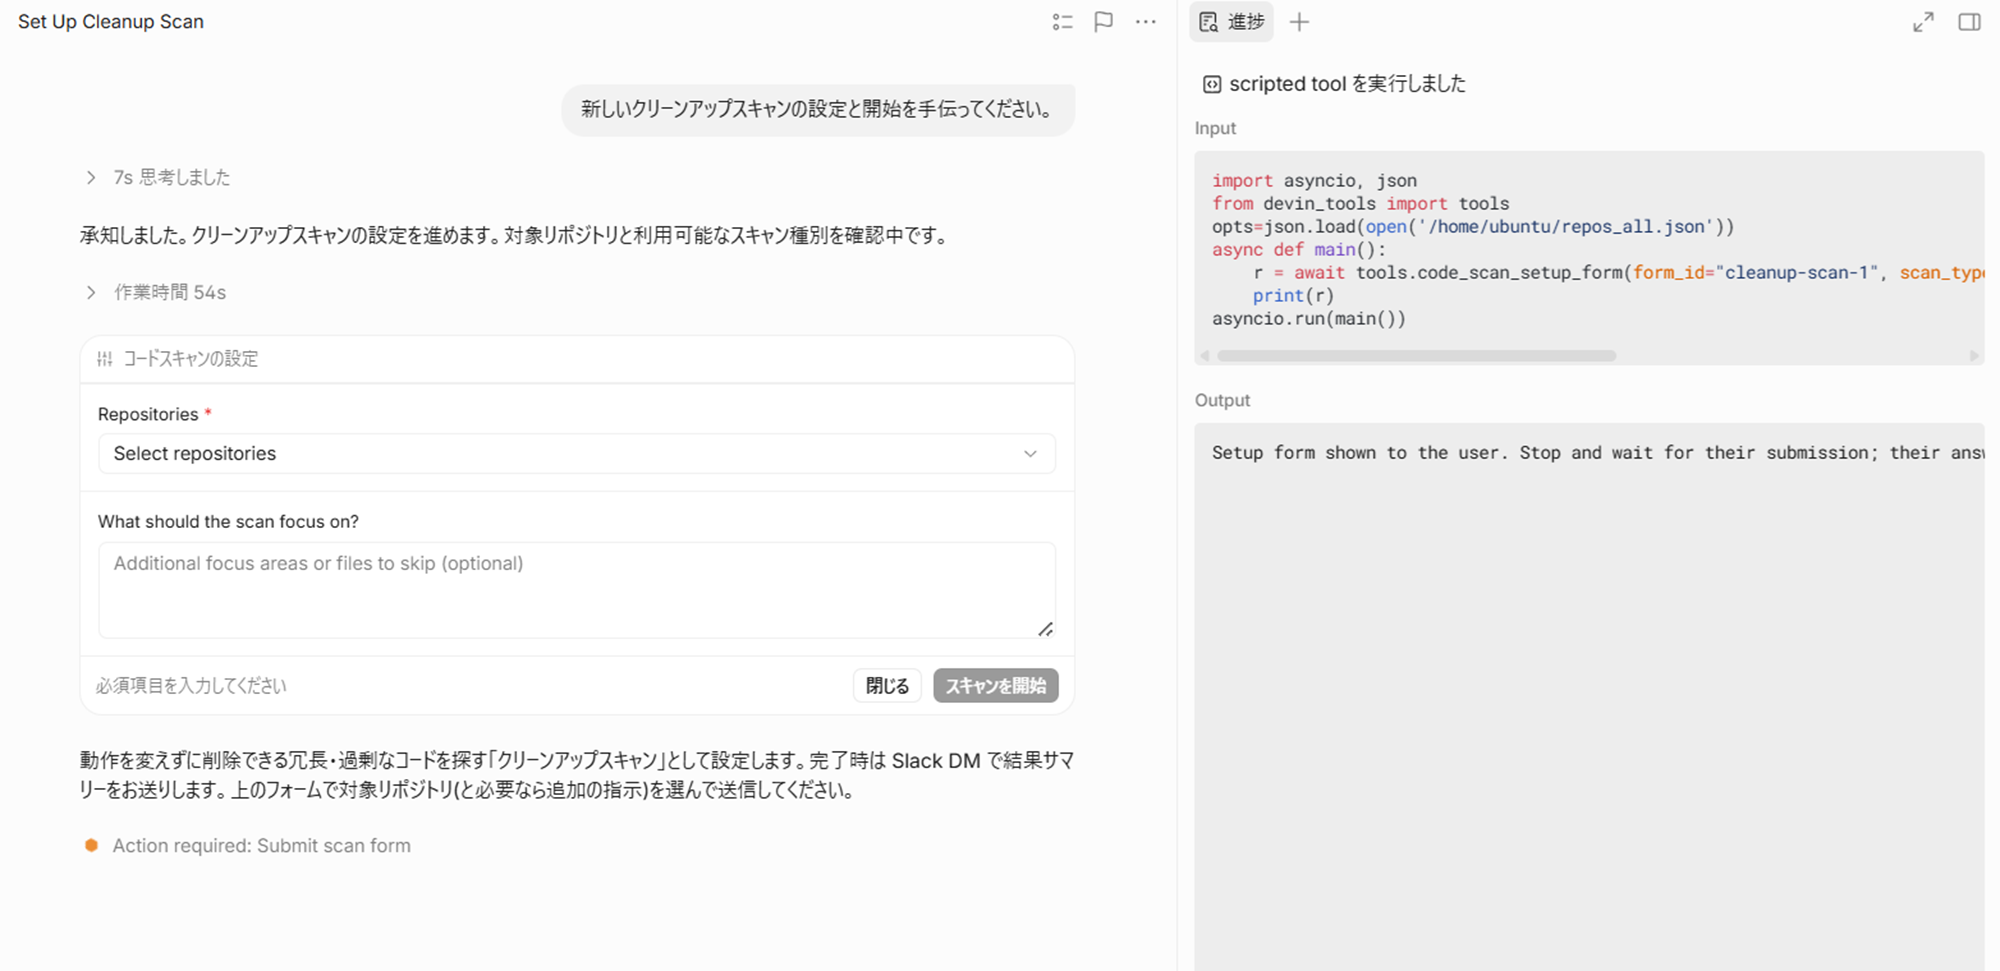
リポジトリは複数指定が可能です。そのためシステムがフロントエンド、バックエンド、共通ライブラリなど複数のリポジトリに分かれている場合でも、一度に調査対象へ含められるのは使いやすそうです。
もう1つ重要なのがFocusです。
ここでは単に「特に見てほしいファイル」を指定するだけでなく、何を問題として扱うか、何を除外するかといった条件も追加できます。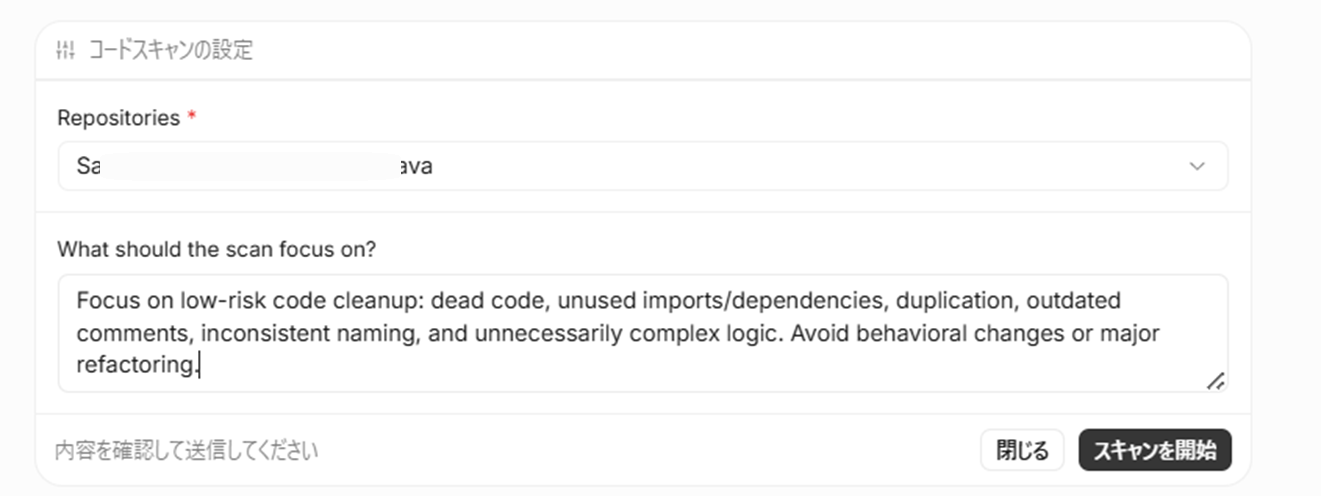
例えば「未使用コードを探す」という場合でも、単純に参照箇所が見つからないという理由だけで削除候補にしてしまうと、DIやReflection、設定ファイルなどから間接的に利用されているコードを誤って判定する可能性があります。
Cognition公式の例でも、未使用コードを探す際に「生成ファイルやテストフィクスチャを除外し、削除を推奨する前に間接参照を確認する」という条件が使われています。
そのため、Focusには「どこを見るか」だけでなく、「どのような条件で判断してほしいか」まで書くと使いやすそうです。
例えばJava/SpringのコードをCleanupするのであれば、次のような追加指示が考えられます。
src/mainを中心に調査してください。target配下と生成コードは対象外としてください。未使用コード、重複処理、不要な抽象化、コードを言い換えただけのコメントを優先してください。未使用と判断する場合は、SpringのDI、アノテーション、Reflection、設定ファイルなどから間接的に参照されていないことも確認してください。
実際に試してみた感想からも、Focusではすべてを細かく指示するのではなく、調査の目的や制約を伝える場所として使うのがよさそうだと感じました。
スキャン中はDevinに任せる
Scanを開始すると、Devinが調査を進めます。
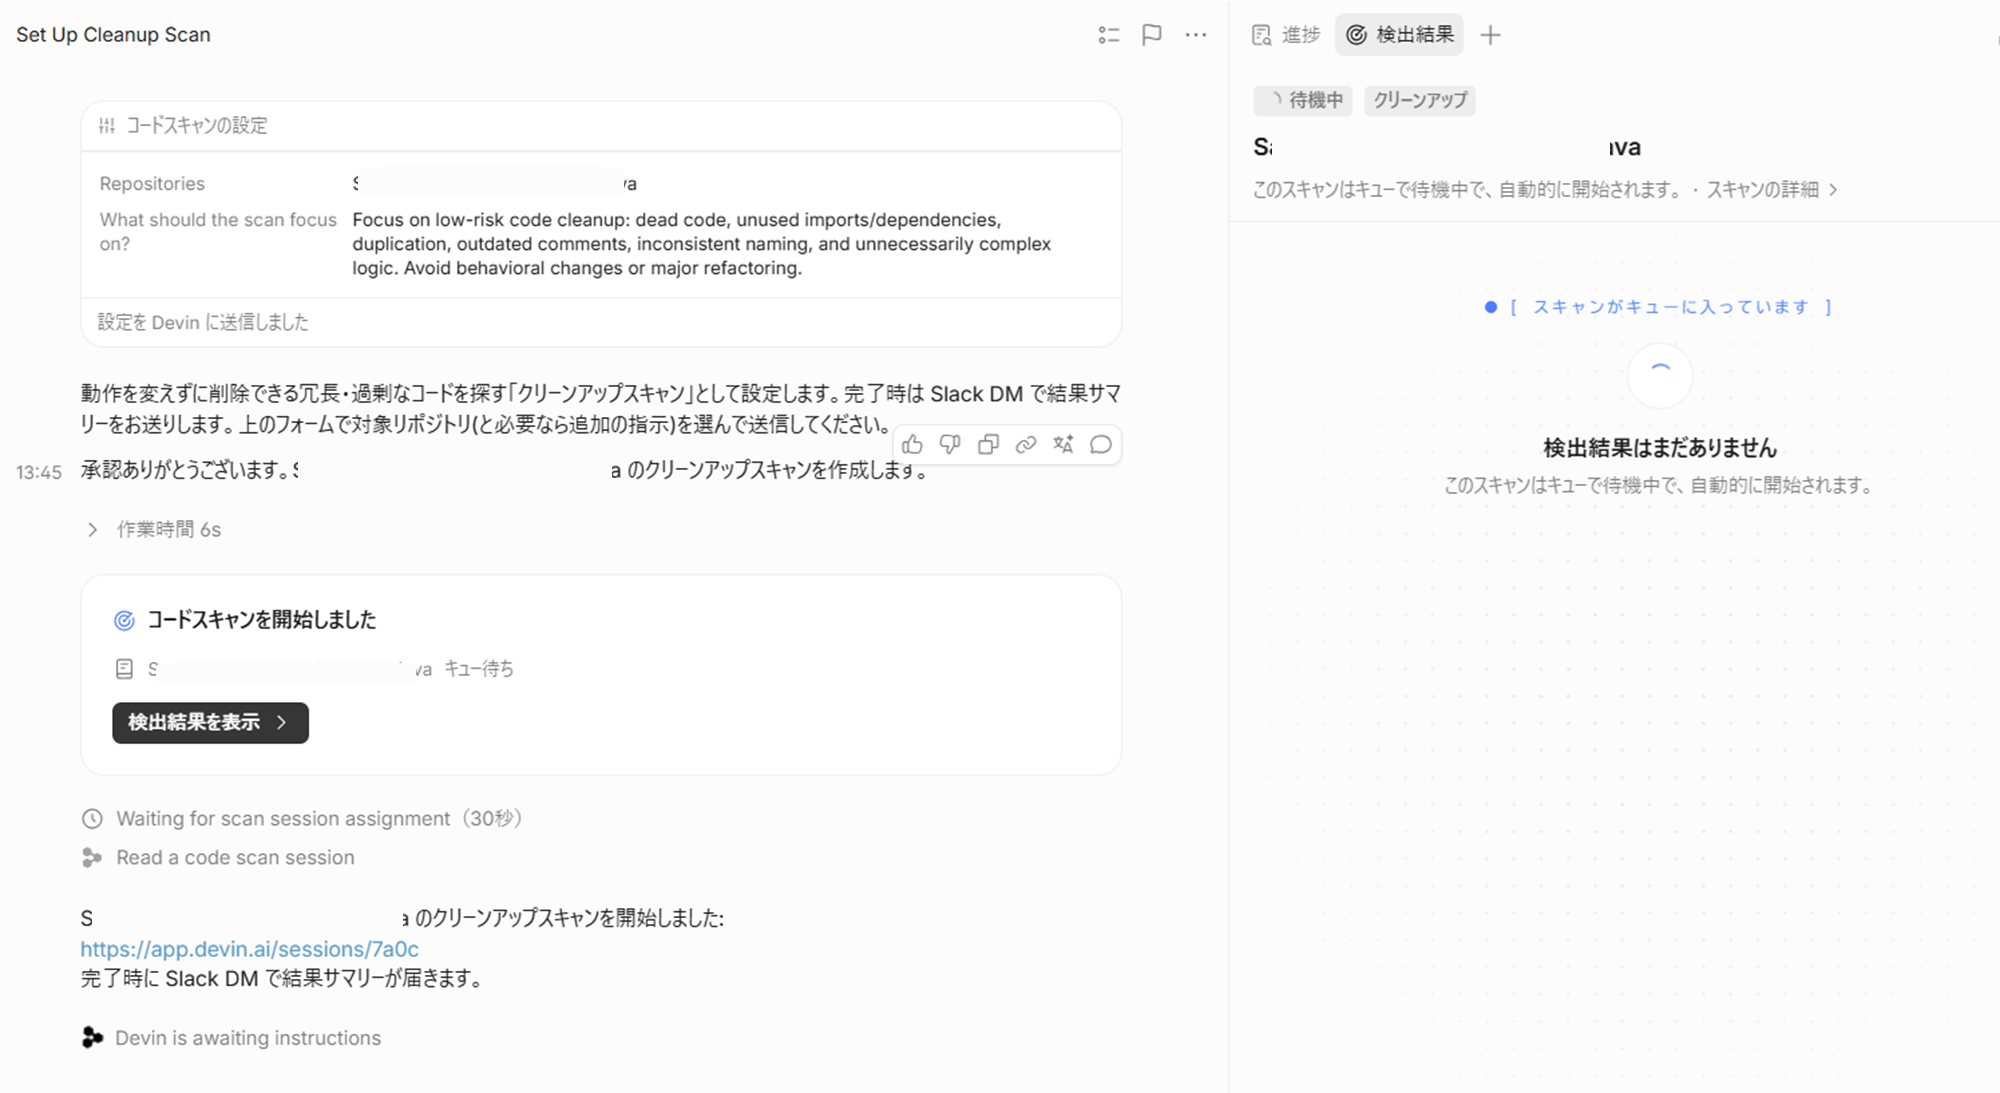 作成されたコードスキャンセッションのAgentタブでは、複数の子セッションが動いて分解されたタスクを実行していることも確認できました。
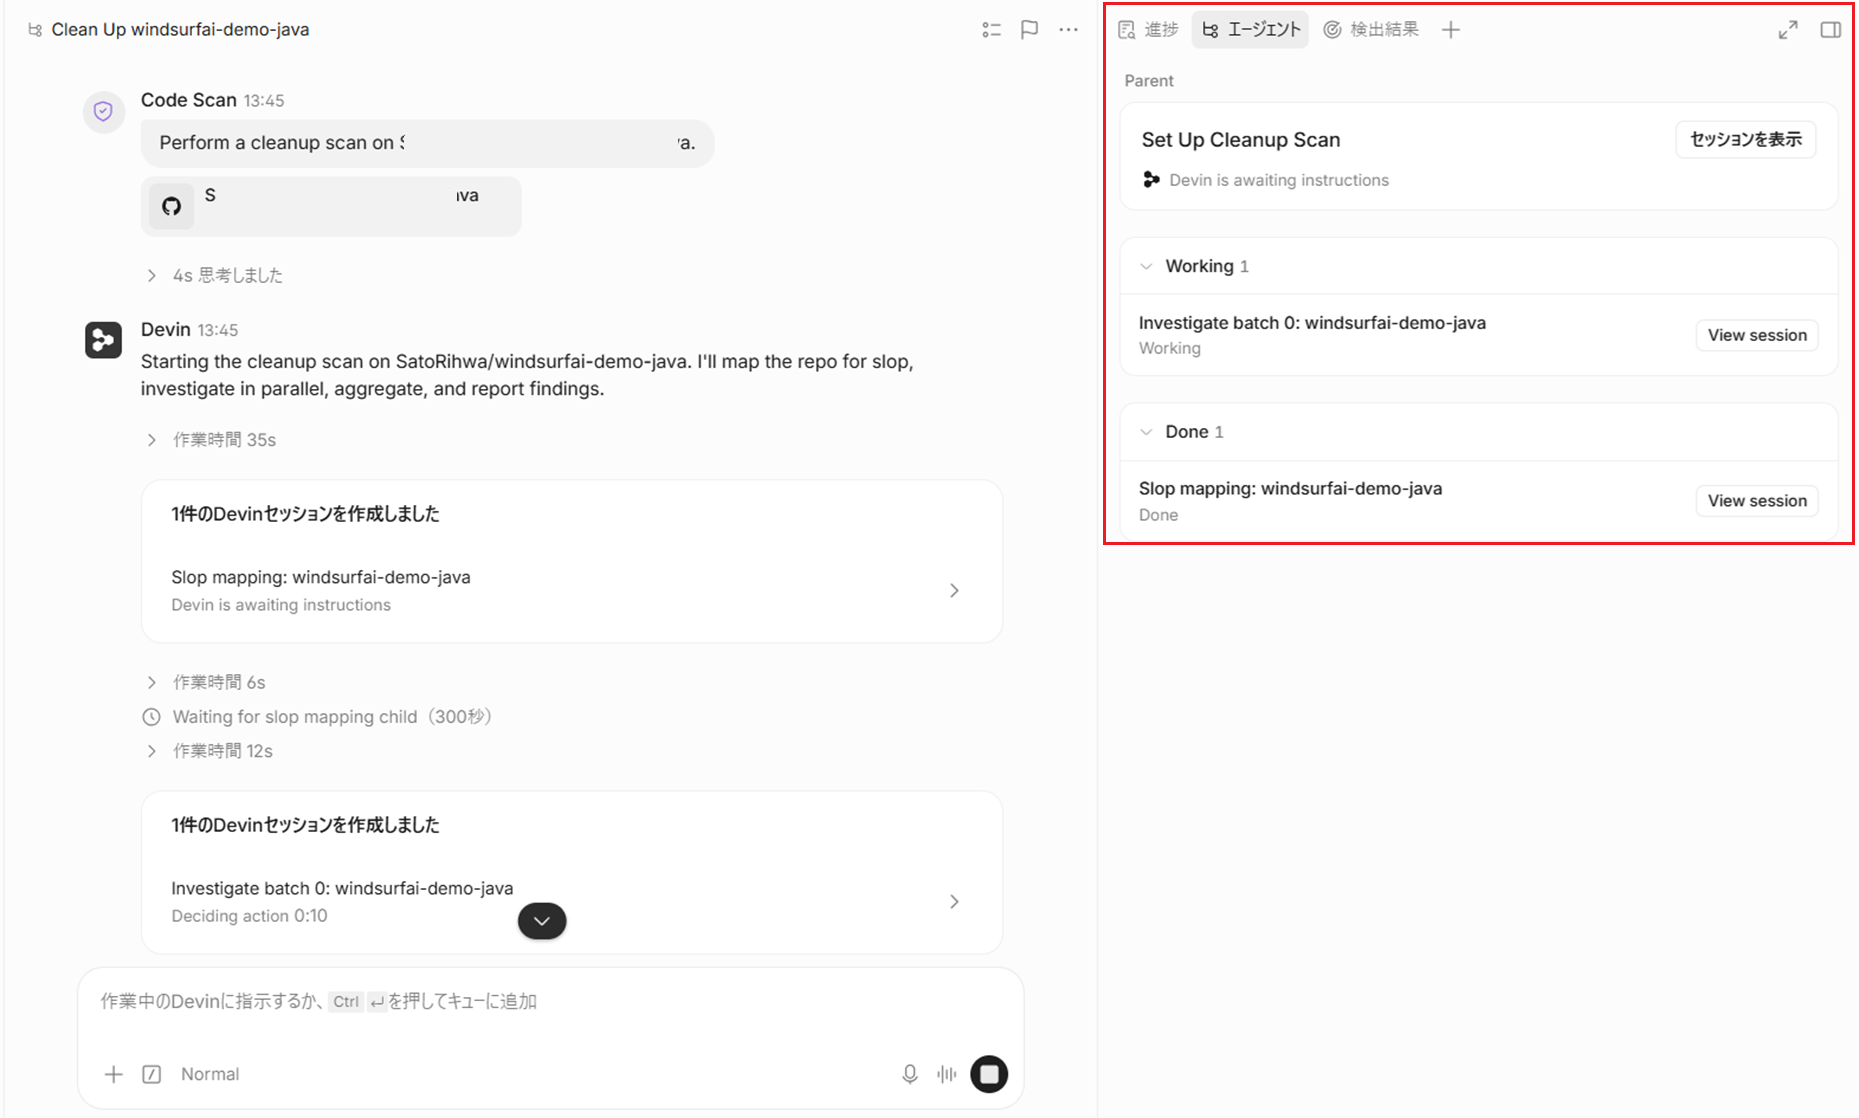
もちろん、ずっと画面を眺めている必要はありません。Scan自体はDevinに任せて、その間に別の作業を進められます。
今回の環境では完了時にSlack通知(連携完了済みかつ通知設定が有効になっている場合に通知されます)も届いたため、処理中は放置しておき、終わったタイミングで結果を確認できました。
一方で、途中でAgent画面を開き、各Devinがどのような調査をしているのかを見るのも個人的には面白いところでした。
Findingsを確認する
Scanが完了すると、見つかった問題がFindingとして一覧表示されます。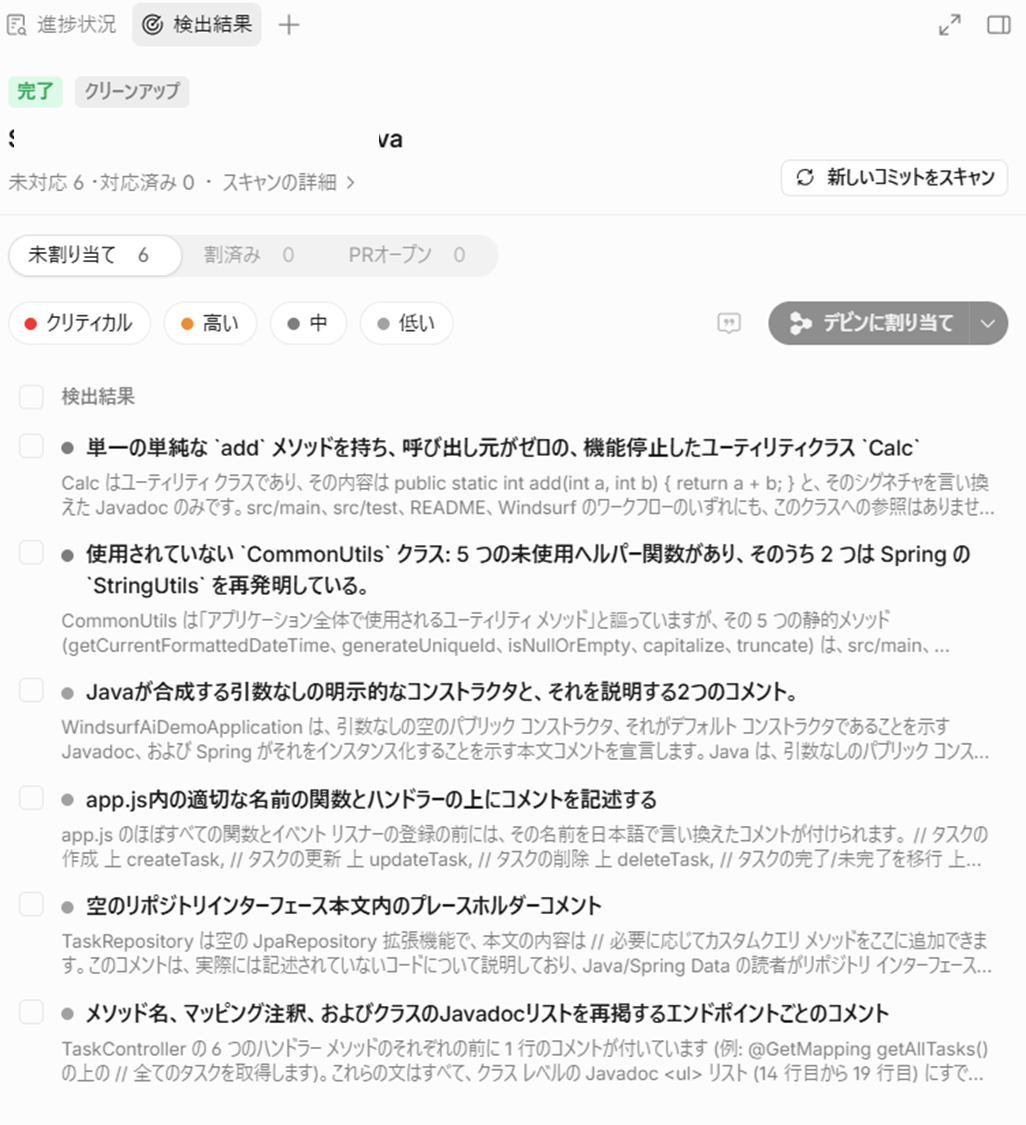
今回試して良かったのは、単に「ここが問題です」と指摘されるだけではなかったことです。Findingを開くと、なぜ問題と判断したのか、その根拠や推奨される修正まで確認できます。例えば、不要と思われるクラスについては、実際に参照箇所を検索した結果も根拠として提示されていました。
AIによるコード解析では、結果そのものだけでなく「なぜその判断になったのか」を人間が確認できることも重要です。その点では、修正するかどうかを判断するための情報が1画面にまとまっており、確認しやすいと感じました。
また今回のCleanup Scanで面白かったFindingの1つが、「コードを見れば分かる内容を説明するコメントが多すぎる」という指摘でした。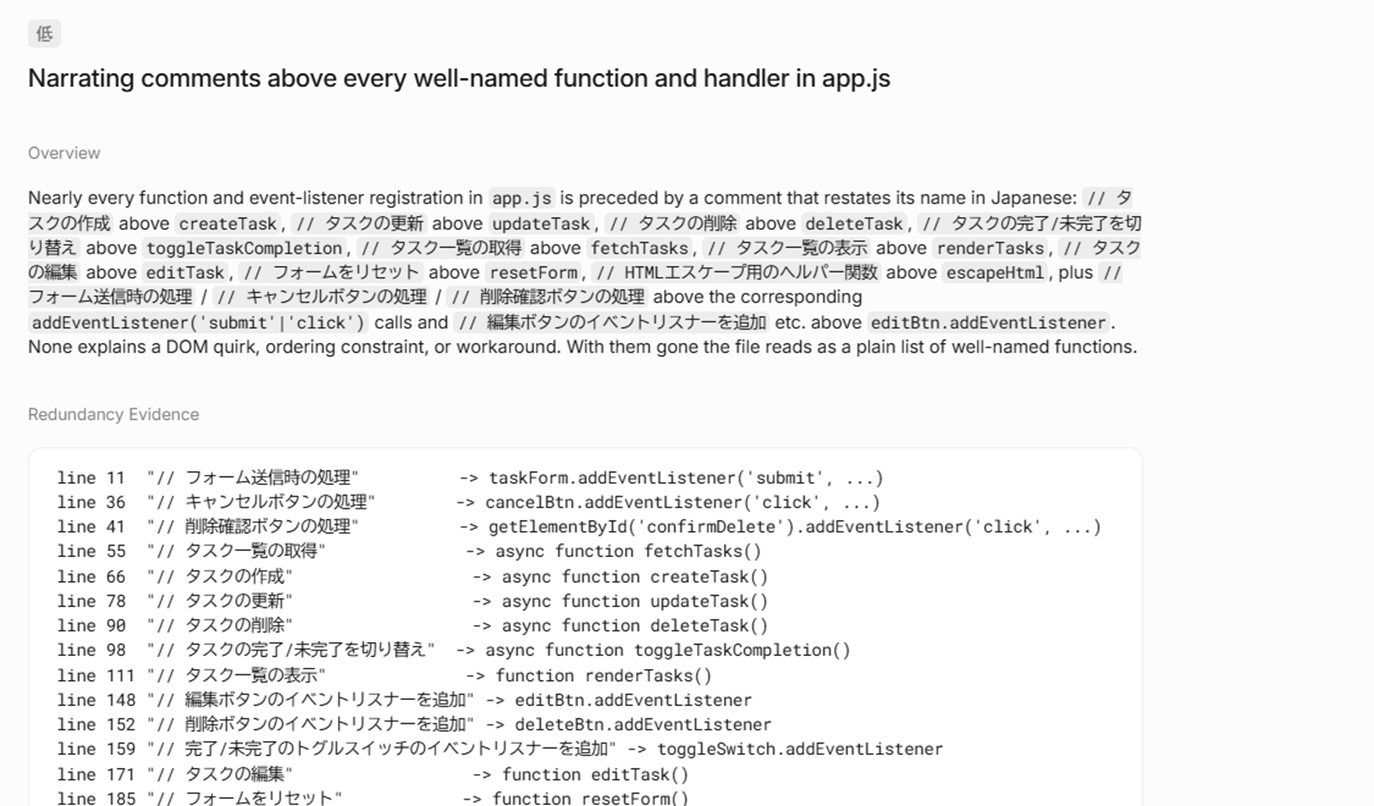
AIにコードを生成させていると、処理内容をそのまま文章にしたようなコメントまで生成されることがあります。実際に今回ScanしたコードもAIで生成したものでした。
もちろんコメントそのものが悪いわけではありませんが、コードを読めば分かる内容まで大量に残っていると、かえって読みづらくなる場合もあります。
Cleanupという名前からは、未使用コードや重複コードの削除を最初に想像していましたが、このような保守性に関する指摘まで出てきたのは少し意外でしたし、面白いと感じました。
また、このFindingではすべてのコメントを一律に消すのではなく、「ここは削除しない方がよい」という判断も含まれていました。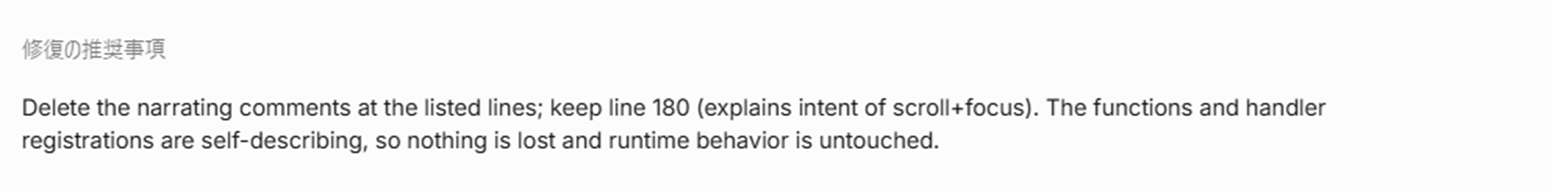
単純なパターンマッチではなく、コードの役割を確認した上で指摘していることが分かり、感心しました。
Findingを見て終わりではない
Code Scansで特に使いやすいと感じたのが、Findingを確認した後の流れです。
まず、Findingはチャットへ追加できるため、その内容についてDevinにそのまま質問できます。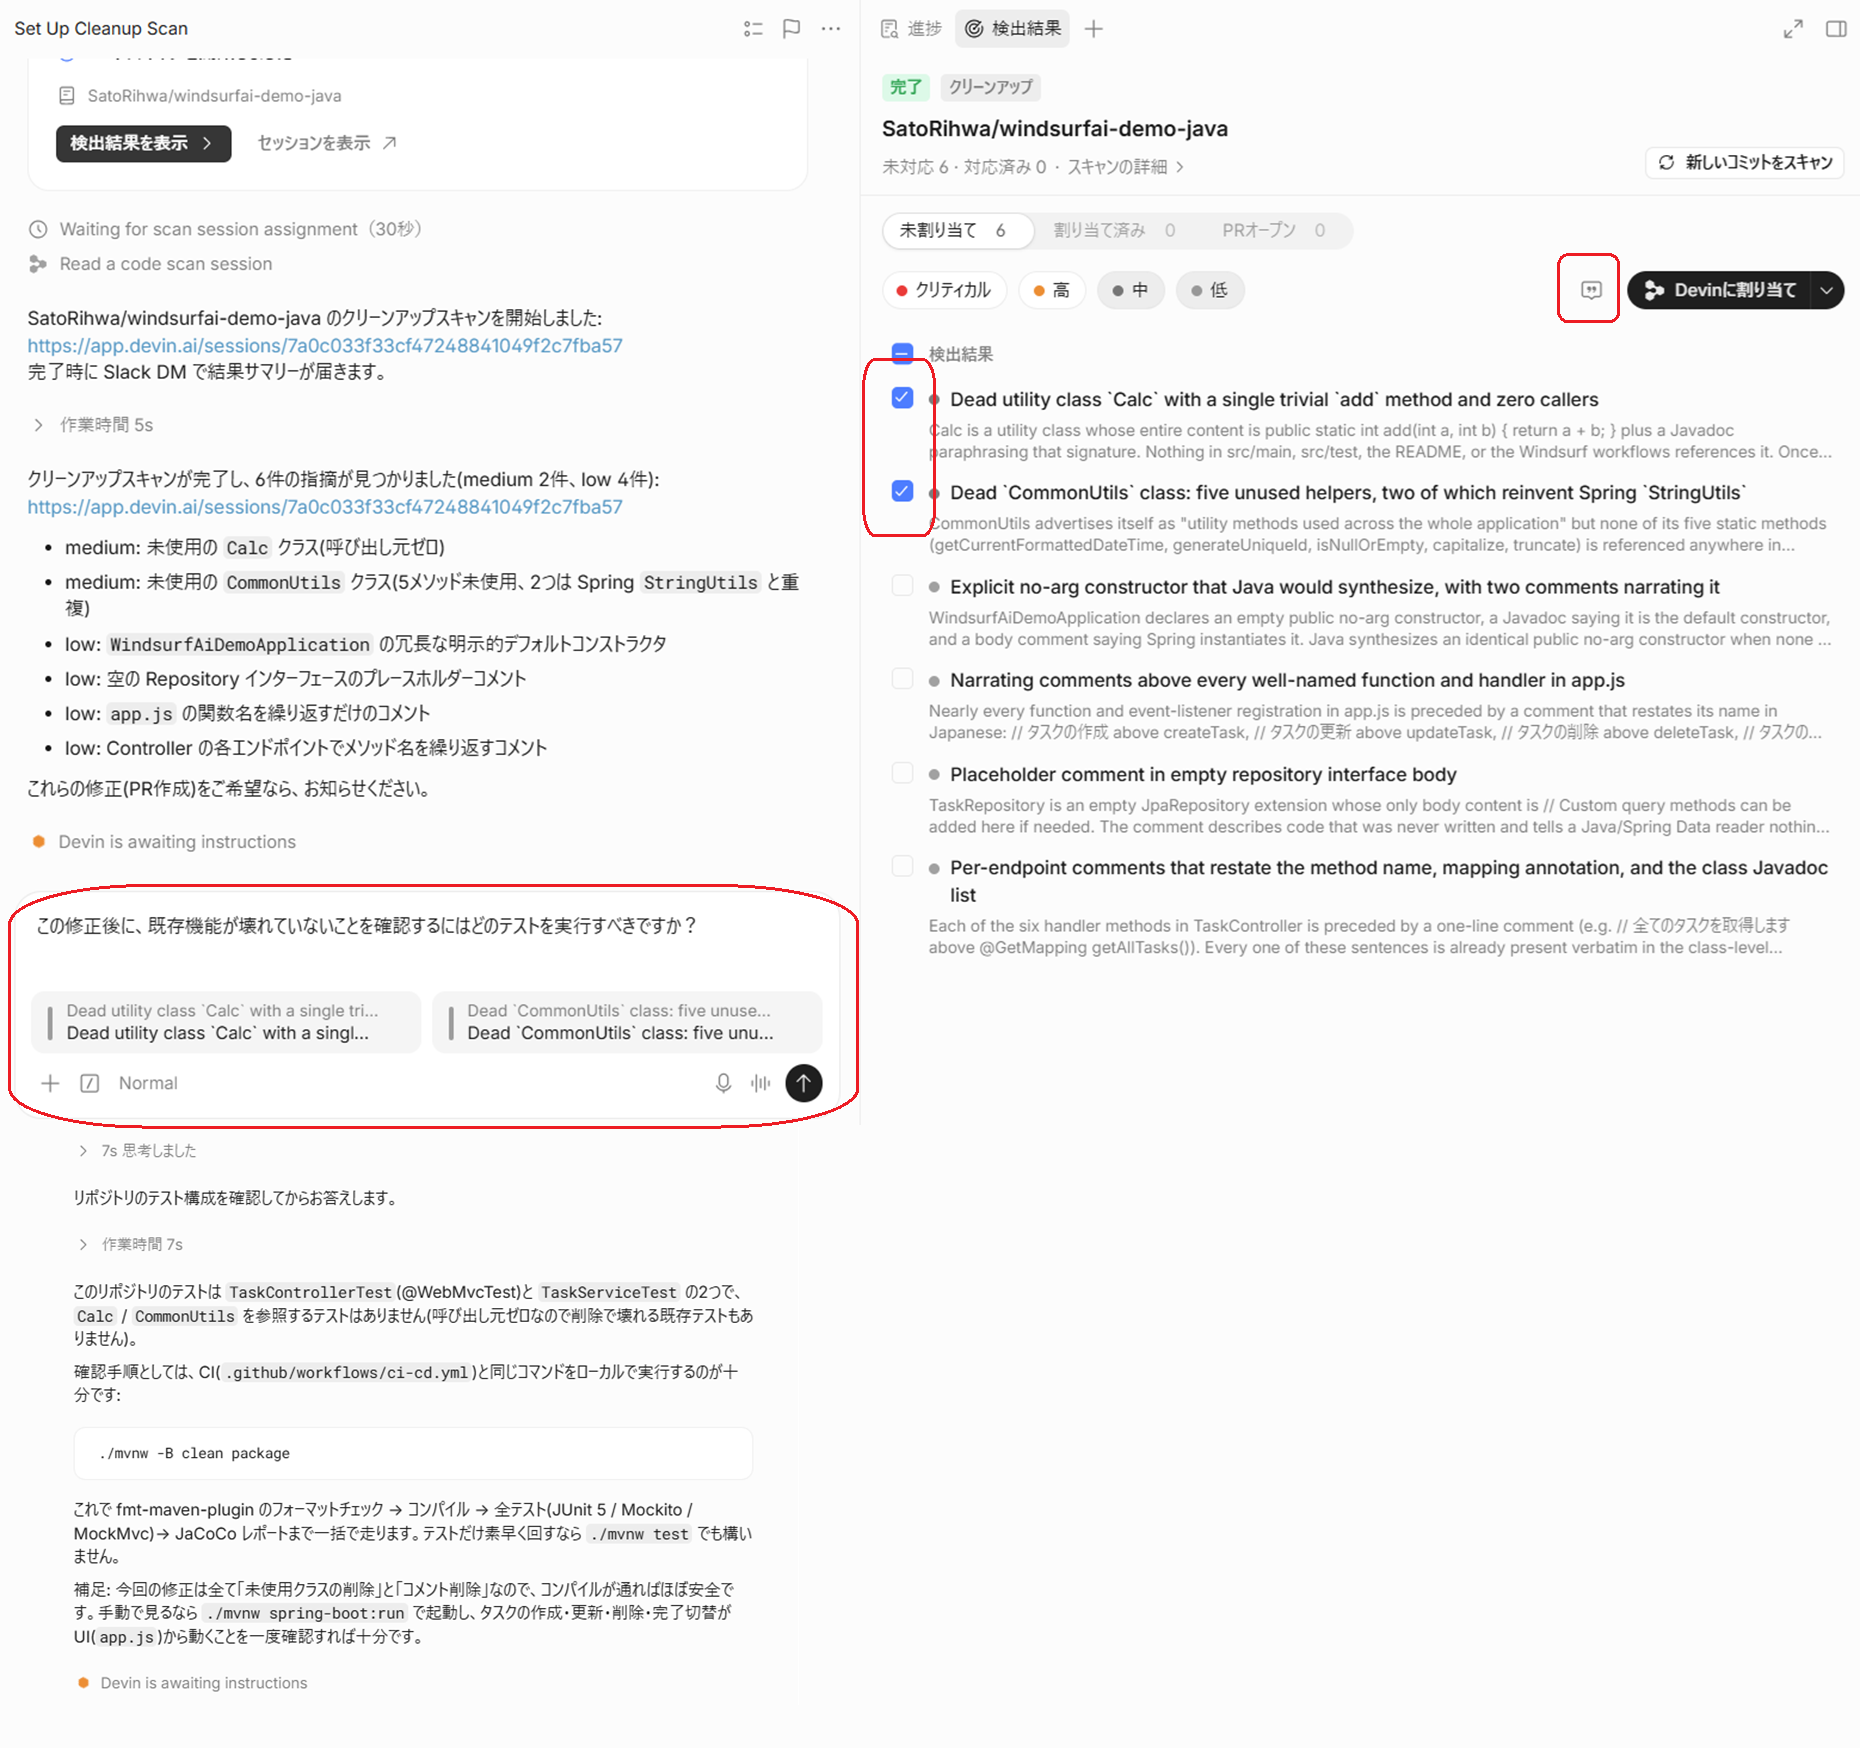
例えば修正内容を確認した上で、「この対応をした場合、デグレード確認ではどのようなテストを行うべきか?」といった追加質問ができます。
解析ツールで問題を見つけても、その後「この指摘は本当に直すべきなのか」「どう直すのか」「直した後に何を確認するのか」を別途考える必要がありますが、Code Scansでは、Findingを起点にそのままDevinとの会話を続けられるため、この切り替えがありません。手間という意味でも、関連する内容を1セッションにまとめるという意味でも、地味に効いてくるポイントです。
さらに、修正したいFindingはそのままDevinへ割り当てられます。Cognitionの公式説明でも、Findingsを確認した後、必要な問題についてDevinにPull Requestを作成させる流れが紹介されています。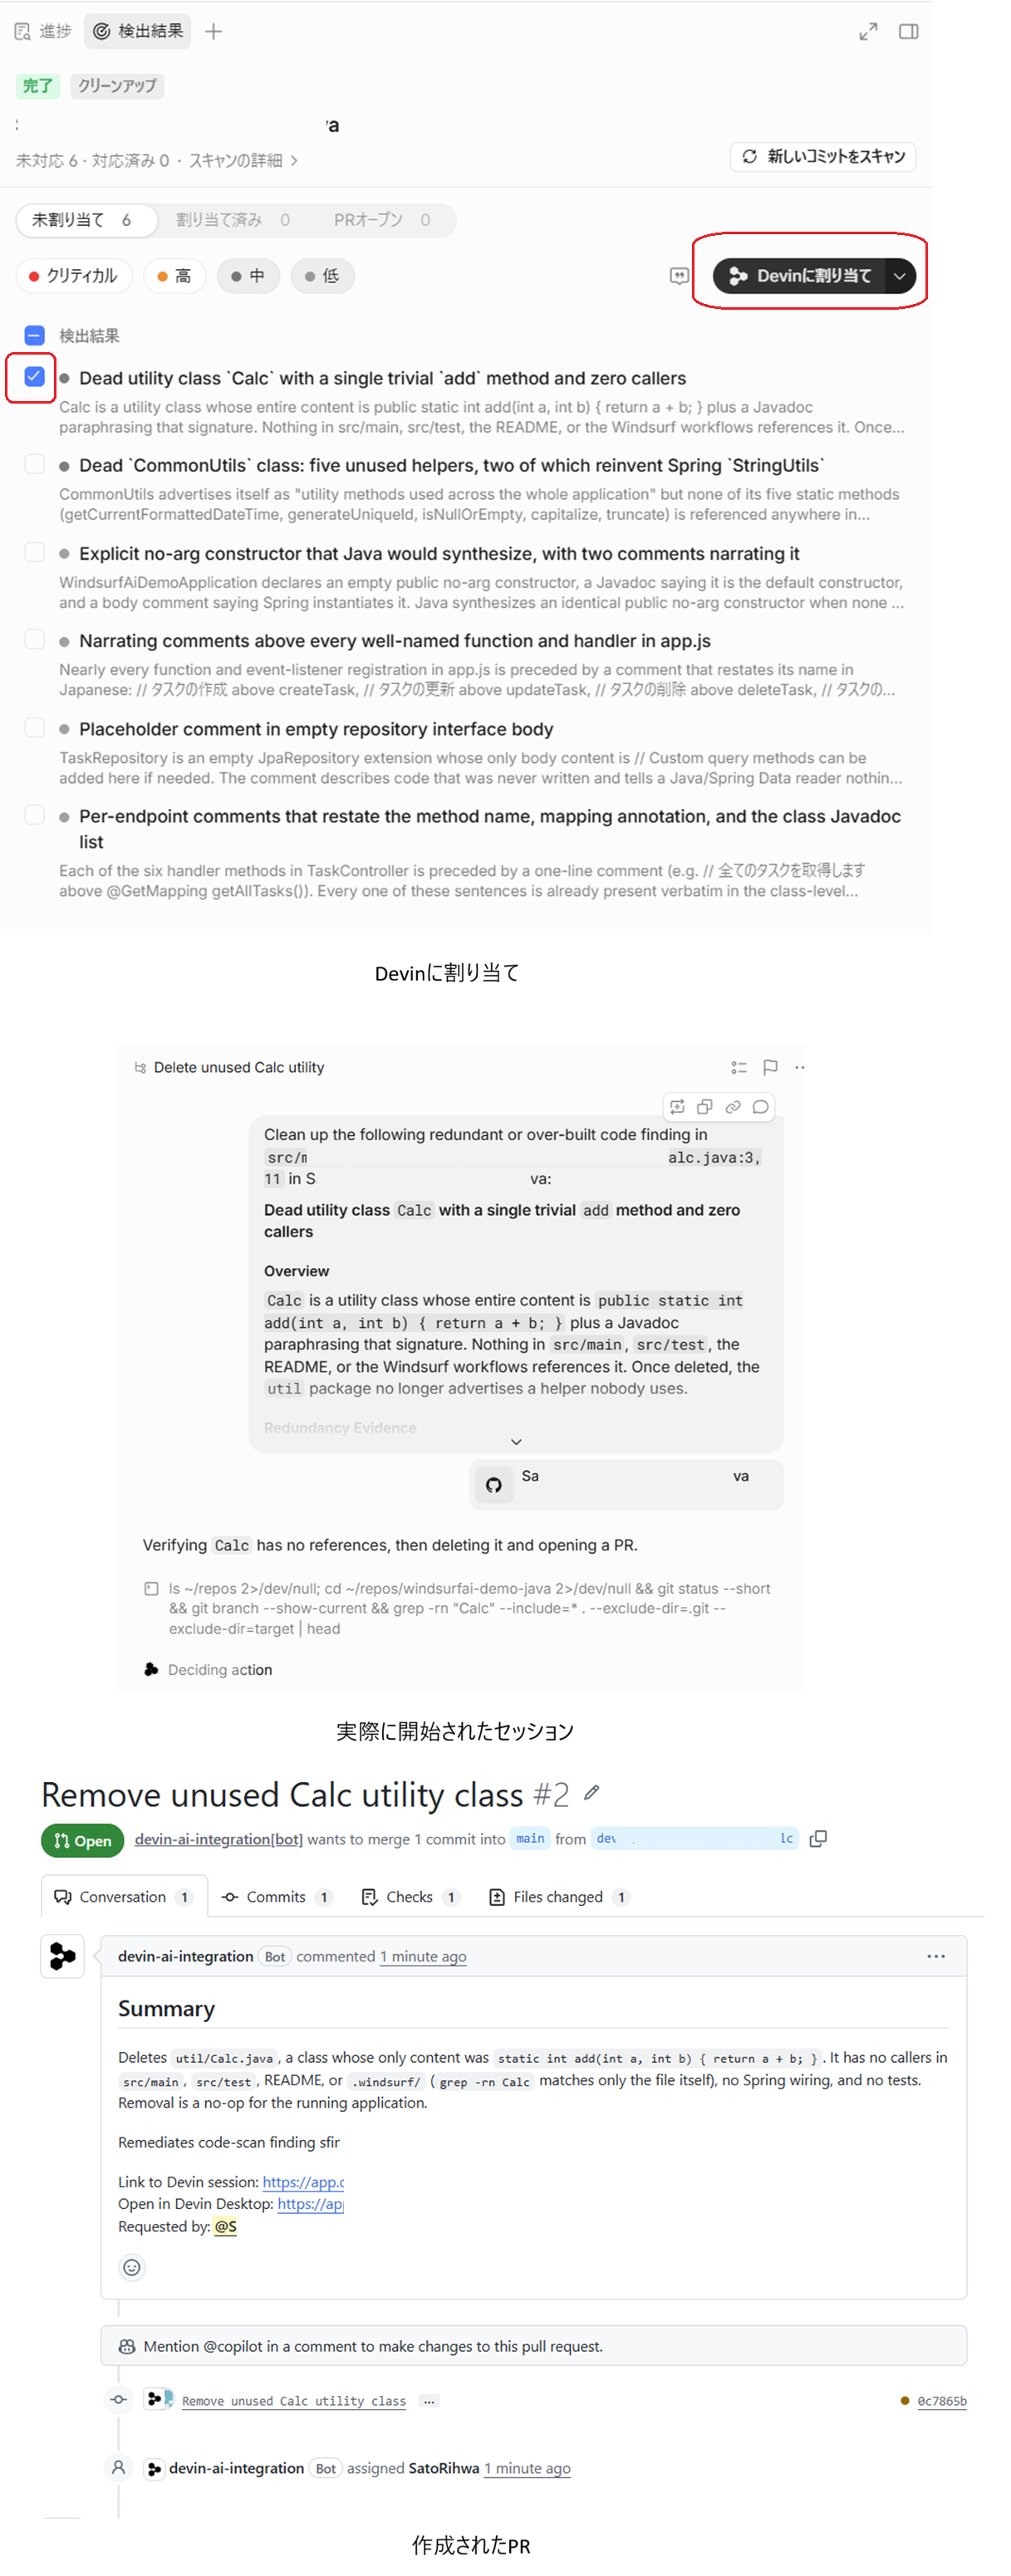
実際に割り当ててみると、新しいDevinセッションが作成され、修正からPull Request作成まで進みました!
また細かいところですが、修正側のセッションから元のScanセッションも確認できるため、後から見たときにも「なぜこの修正を始めたのか」をたどりやすく、こうした導線もよく考えられていると感じました。
修正したPRをDevin Reviewにかけてみる
Scanの機能からは外れますが、今回は上記で作成されたPull RequestをDevin Reviewでも確認してみました。Devin Reviewについてはこちらの記事も併せてご参照ください。
すると、別の指摘が出てきました。
ソースコード上ではクラスが削除されていましたが、リポジトリで管理されているtarget配下には、削除前に生成されたクラスファイルが残っていたのです。
※本来target配下はリポジトリで管理するものではありませんが、今回は含まれてしまっていたようです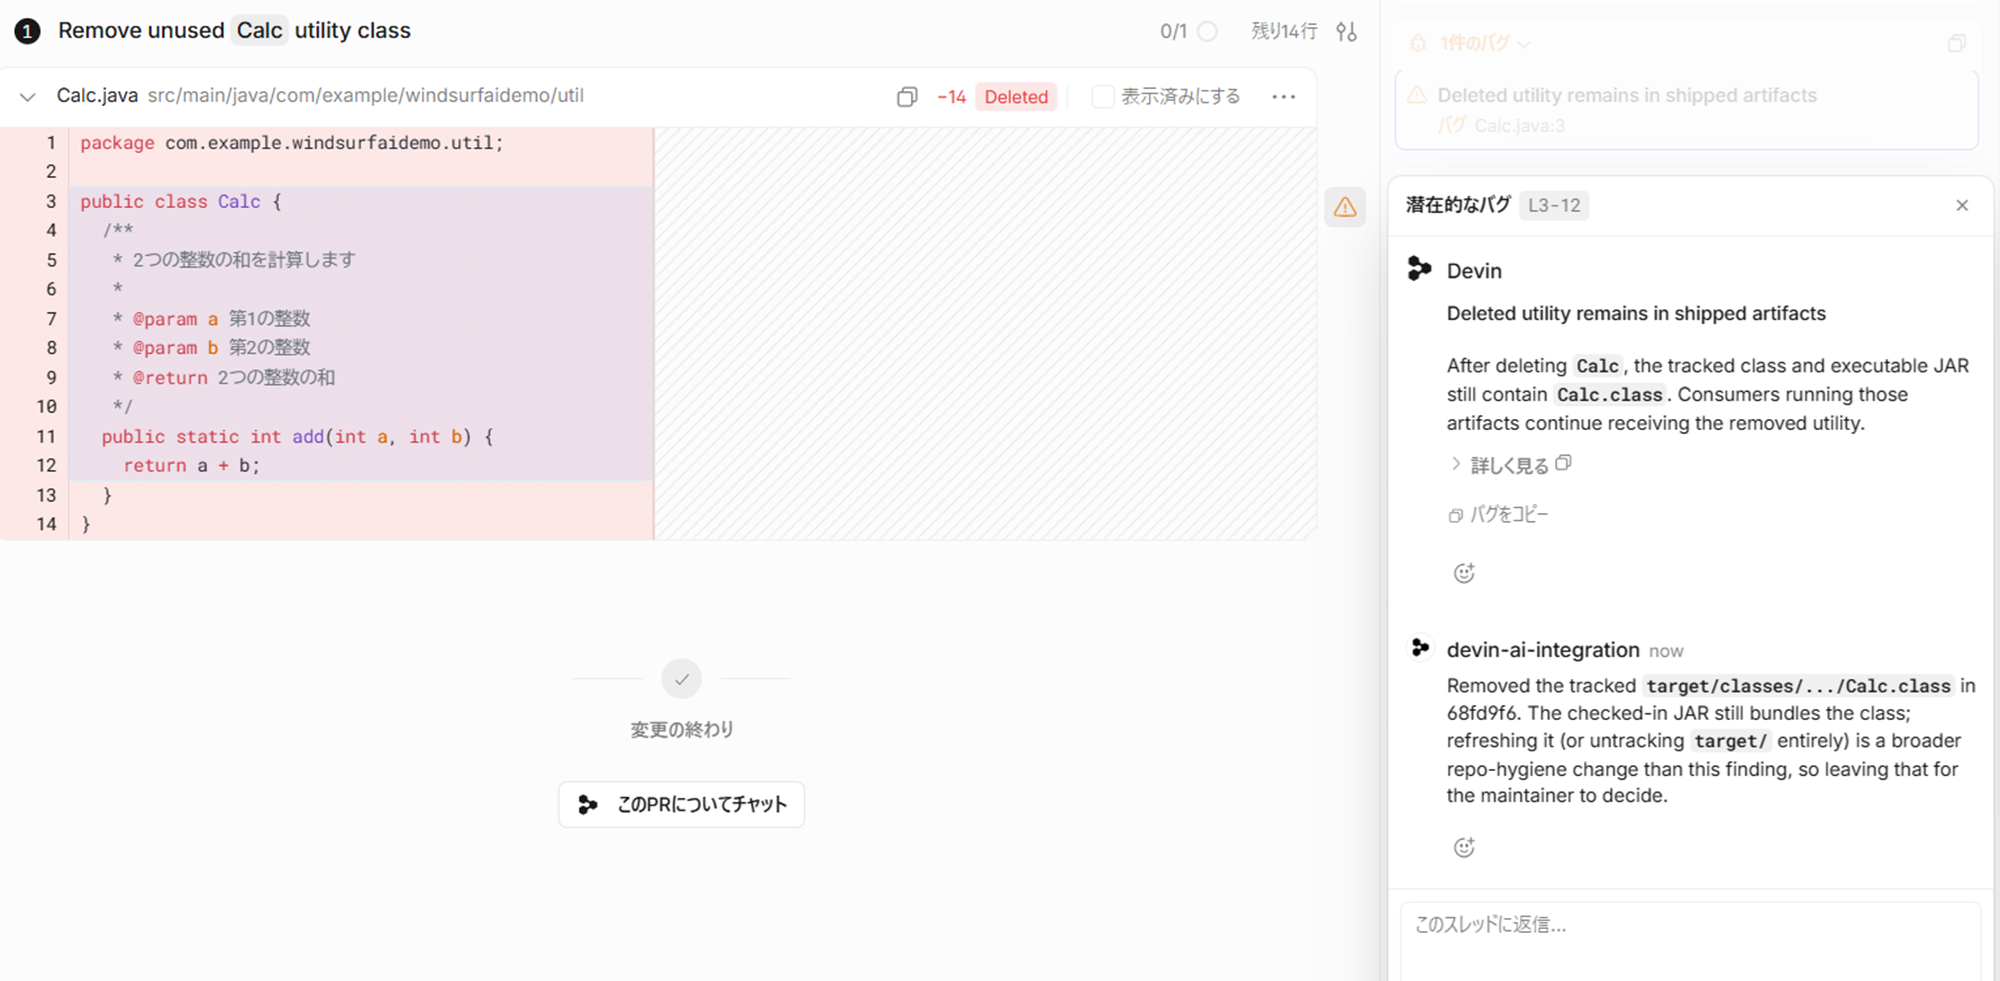
一見すると、「なぜCode Scansや修正時にこちらも消さなかったのか」と思う部分です。実際、私も初見ではまずその疑問が浮かびました。
ただ、今回のScanではtarget配下を調査対象としていませんでした。また、Devinによる修正でも未使用クラスの削除というFindingに対応する一方で、「そもそもtargetをGit管理するべきなのか」という別の問題までは変更を広げていません。
その後、生成されたクラスファイルについては削除しつつ、JARの再生成やtarget全体をGit管理から外すことについては、今回のFindingより広いリポジトリ管理上の変更として扱われたということだと推測されます。
この挙動は興味深いところで、関連しているからといって何でも変更するのではなく、今回依頼された作業の範囲と、それを超える改善を分けていることが分かります。
そして、Code Scansで見つけた問題をDevinが修正し、そのPRをDevin Reviewが別の視点から確認する、という流れも実際に試すことができてよかったです。
どのような場面で使いやすそうか
今回試してみて、Code Scansは「リポジトリ全体を、決めた観点で横断的に調査したい」ときに特に使いやすそうだと感じました。
例えばデータベース関連の調査です。
特定の不具合を直すのではなく、リポジトリ全体からN+1クエリや不要なDBアクセスなどを探す場合、通常は確認対象が広くなります。Database queriesのように調査観点を決めて全体を見る使い方は、実際の開発でも取り入れやすいのではないでしょうか。
もう1つ気になったのがMigration planningです。
Devinは既存システムの改修やマイグレーションにも使えますが、実際に移行作業を始める前には、既存の依存関係や処理フロー、ビジネスロジック、外部連携などを整理する必要があります。
これまでもDevinに調査を依頼することはできましたが、何を調べてもらうのかを考え、プロンプトを作り込んでいた方もいると思います。
Migration planningでは、依存関係やEnd-to-Endの処理フロー、既存のビジネスロジックを追跡し、移行計画につなげる用途が公式にも想定されています。
そのため、マイグレーション作業そのものだけでなく、その前段階の調査を始める取っ掛かりとして使えるのは、Devinのユースケースとも相性が良さそうだと感じています。
気になったところ
現時点では結果が英語
今回の環境では、Findingsは英語で表示されました。
そこでScan実行前に「結果は日本語で出力する」と指示してみました。指示自体はFocusへ反映されたものの、実際のFindingsは日本語にはなりませんでした。
内容自体はブラウザの翻訳機能を使えば確認できますが、日本語環境で日常的に使うことを考えると、結果や通知も含めてローカライズされるとさらに使いやすくなりそうです。
調査範囲は考えて使いたい
Code Scansはコードベースを横断的に調査し、対象を分割して複数のAgentで処理します。そのため、ちょっとしたコード確認まで毎回Scanするというよりは、「この観点でリポジトリ全体を調べたい」という場面で利用する方が合っていると感じました。
実行量は単純なリポジトリサイズだけではなく、指定した範囲や条件、実際に調査対象となる箇所などにも左右されると考えられます。
特に大きなリポジトリでは、最初から何でも対象にするのではなく、目的に合わせてFocusや対象リポジトリを設定し、調査範囲を考えながら使うのがよさそうです。
まとめ
実際にCode Scansを試してみて、特に印象に残ったのは、リポジトリ全体を特定の観点から調査できることと、見つかった問題をそのまま修正作業へつなげられることです。
例えば、CleanupやDatabase queriesといった目的を選ぶだけで、コードベース全体から該当する問題を探せます。さらに、調査結果として表示されたFindingは、内容を確認したり、Devinに追加で質問したり、そのまま修正を依頼したりできます。/scanから始まり、Findingの確認、追加の調査、Pull Requestの作成までが一続きになっているため、調査と実装の間で作業が途切れにくい点も使いやすく感じました。
今回は大規模リポジトリそのもので性能を検証したわけではありませんが、Devinがこれまで培ってきた「広いコードベースを一度に扱うのではなく、調査対象を分割し、複数のDevinが並行して確認した上で結果をまとめる」という特性をしっかりと感じることができたのも嬉しいポイントでした。
そしてこれまでDevinを使う際には、人間があらかじめ具体的なタスクを定義して渡す必要がありました。Code Scansでは、その前段階にある「どこに問題があるのかを探す」「どこに改善すべきところがあるのかを探す」という作業から任せられます。調査結果を人間が確認し、必要なものだけを修正へ進めるという流れを作りやすい点に、Code Scansの価値があると感じました。
一方で、見つかったFindingをすべてそのまま修正するのではなく、根拠を確認して、対応するものを人間が選ぶこともできます。
Devinが広く調査し、人間が結果を確認し、必要なものをDevinに戻して修正する。
Code Scansは、そんな使い方がしやすくなる機能だと感じました。
著者紹介
SB C&S株式会社
ICT事業本部 技術本部 技術統括部 第2技術部 2課
佐藤 梨花
勤怠管理システムの開発(使用言語:Java)に約8年間従事。
現在はエンジニア時の経験を活かしたDevOpsやDX推進のプリセールスとして業務に精励しています。