はじめに
こんにちは。SB C&Sの佐藤です。
AIに仕事を依頼する際、もちろんAIコーディングエージェントを使う際にも、「どのモデルを使うか」は重要な選択肢の一つです。
高性能なモデルを使えば複雑なタスクにも対応しやすくなりますが、その分コストは高くなります。一方、安価なモデルですべてを処理しようとすると、複雑な判断や調査が必要な場面で手戻りが増え、結果としてコストも品質も悪化する可能性があります。
では、1つの開発タスクの最初から最後まで、同じモデルを使い続ける必要はあるのでしょうか。作業量の大きな内容を任せることも多いコーディングにおいて、ここはしっかりと検討する必要があるポイントになると思っています。
この考え方に対するCognitionのアプローチの一つが「Devin Fusion」です。
今回はDevin Fusionの仕組みを確認しながら、実際の不具合修正タスクを使って、モデルの役割分担によって品質やコストがどのように変わるのかを検証します。
目次
Devin Fusionとは
Devin Fusionは、複数のモデルを組み合わせて1つの開発タスクを処理するモデルルーティングの仕組みです。2026年6月にDevin Cloud向けのPreviewとして公開され、その後2026年9月にはDevin DesktopとDevin CLIにも展開されています。
Fusionでは、高い推論能力を担うLeadと、作業を委譲されるSidekickという2つの役割を持つエージェントが動作します。1点注意点としてDesktop / CLIでは、それぞれに使用するモデルをユーザーが選択できますが、Cloud版ではFusionがモデルの使い分けを内部で制御するため選択は不可能となっています。
それぞれの役割として、Lead側はタスク全体の計画、曖昧な要件の解釈、Sidekickへの作業依頼、結果のレビューなどを担当します。
一方Sidekickでは、比較的コスト効率の高いモデルを配置し、Leadから具体化された作業を受け取り、コードの調査、実装、テストなどを進めます。
これらのエージェントがタスクの内容によって自動で担当を振り分けられながら実装されていく、というのが大まかな動きです。
ここで重要なのは単純に「簡単なタスクなら安いモデル、難しいタスクなら高性能モデル」と切り替えているわけではないということです。
LeadとSidekickはそれぞれ独立したコンテキストとツールを持って動作し、LeadからSidekickへは、作業内容や制約、成功条件などをまとめた指示が渡されます。Sidekickが作業を終えると結果をLeadへ返し、Leadが内容を確認します。必要であればLead自身が作業を引き取ることもあります。
Cognitionの説明では、この構成によって高性能なモデルをタスク全体の判断役として維持しながら、一部の作業をよりコスト効率の高いモデルへ委譲できるとされています。
以下の公式ブログではベンチマークや具体的な削減コストについても触れられているため、是非併せてご覧ください。
- Cloud:Devin Fusion: Frontier Performance at 60% Lower Cost
- Desktop / CLI:Introducing Fusion in Devin Desktop & CLI
Devin Fusionの必要性
Fusionについて調べていて個人的に興味深かったのが、利用によるメリットが単純なコスト削減だけの話ではないという点です。
一口に「コードを修正する」といっても、エージェントが行う作業は一種類ではありません。高い推論能力が重要になる工程もあれば、方針が決まれば比較的機械的に進められる工程もあります。
不具合修正を依頼した場合で言えば、「不具合の原因を推測する=なぜこの条件でだけ不具合が発生するのか」を考える作業と、「コードを変更する=指定されたクラスを修正してテストを実行する」作業では、モデルに求められる能力は同じではなく、後者の方が機械的な処理になることが分かります。
そこで対策となるのが、タスクの難易度によって使用するモデルを切り替える方法です。
しかし、これも簡単ではありません。
CognitionもFusionの説明で、最初に与えられたプロンプトだけではタスクの本当の難易度を判断できないということを指摘しています。「このバグを直して」という依頼でも、1行の修正で済むかもしれませんし、コードを調査した結果、設計そのものに原因があることが分かるかもしれません。
つまり、「このタスクは簡単そうだから安価なモデルに任せる」と開始時点で決めても、調査を進めなければ本当に簡単なのか分からないわけです。
さらに、モデルを途中で単純に切り替える方式では、コンテキストやPrompt Cacheの扱いも課題になります。
これに対してFusionではLeadとSidekickがそれぞれ継続したコンテキストを持ち、会話履歴全体ではなく、必要な指示と結果をやり取りすることでこの問題に対応しています。
またここでモデルの選択がコストだけでなく、成果物の品質にも影響するという点も併せて考えていきます。なぜなら、安価なモデルにすべて委譲して最初の調査や設計判断で方向を間違えてしまえば、その後どれだけ正確にコードを書いても正しい成果物にはならない可能性が高いからです。
逆に、高性能なモデルが最初に方針を適切に決め、その後の明確になった実装作業を別のモデルへ任せられるのであれば、すべての工程を高性能モデルで処理する必要はないかもしれません。
Cognitionは、モデルを評価する際にも「Price per Token」だけではなく、「Price per Task」で考えるべきだとしています。
単価の高いモデルでも、より少ないやり取りで適切な判断ができれば、タスク全体では安くなる場合があるためです。実際、Cognitionの検証では、Leadモデルをより高性能なモデルへ変更した結果、トークン単価は高くなったにもかかわらず、Fusion全体の平均コストが低下したケースも報告されています。
こういったことから、これからのAIコーディングでは「開発工程のどこで、どのタスクで、どの能力を持つモデルを使うか」まで含めて考える必要が出てきていると言えます。
実際に試してみた
今回は、Devin CloudのFusionを使って実際に検証します!
題材は単純なコード変更ではFusionの役割分担が見えにくいため、「原因調査」「判断」「実装」「テスト」が必要になる不具合修正を題材にしました。
検証用内容
検証には、Java 21 / Spring Boot 3.xで作成した簡易的な注文管理APIを使用しました。機能として、顧客ランクによる会員割引と商品単位のセール割引を実装しています。
この割引に関して正しい仕様では、「商品ごとのセール割引を適用した後、その金額に対して会員割引を適用する」という順番で計算します。
しかし、検証用アプリには意図的に不具合を入れています。
GOLD会員が複数の商品を購入し、その中にセール対象商品が含まれている場合だけ、会員割引の計算対象となる金額が間違ってしまうというものです。
一方、既存の自動テストにはこの組み合わせのテストを含めていません。そのため、初期状態でもすべての既存テストは成功します。
検証用アプリの実装に関して、検証対象となるコード自体をDevinに作らせると、過去のセッションなどが結果に影響する可能性を完全には排除できないため、今回は検証用アプリケーションの作成にはClaude Codeを使用しました。
Devinには不具合の原因や正しい実装箇所は伝えず次のような症状だけを提示し、Lite(速度 / 効率を重視した軽量モード)、Fusion、Ultra(調査 / 検証の深さを重視した高精度モード)の3モードでDevinがどのように原因を調査して修正するのかを確認します。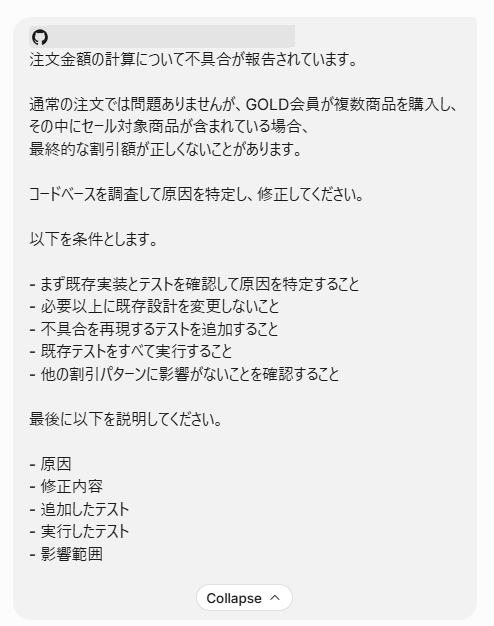
修正結果:3つとも同じ
まず不具合コードの修正について、3つのモードで修正内容にはほとんど差が出ませんでした。
Lite、Fusion、Ultraのすべてが同じ原因を特定し、会員割引の計算対象をセール適用前のoriginalSubtotalから、セール適用後のsubtotalAfterSaleへ変更しました。
実装修正としては1行です。
今回の不具合は原因さえ見つければ修正自体は非常に単純だったため、モデル差が出にくかったのだと思います。この点については、今後もう少し調査や設計判断が必要になる複雑なタスクでも試してみたいところです。
一方で、かなり差が出たのが修正後の検証でした。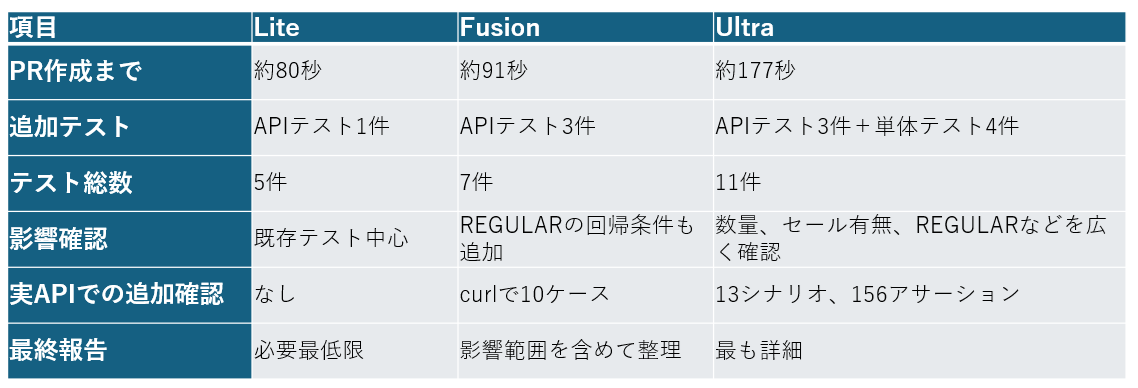
上記の内容を見ても、Liteは必要最低限の再現テスト、Fusionはそこに回帰確認を追加、Ultraはさらに単体テストと実API検証を広げる、という差が出ました。
ではそれぞれのモードをもっと細かく見ていこうと思います。
Lite:必要最低限
Liteについて、「必要なことだけをやる」という性格がかなり明確に表れていると感じました。
原因は正しく特定できていますし、修正内容も正しく、不具合を再現するテストも追加されているので、そういった意味では今回の依頼自体には対応できています。
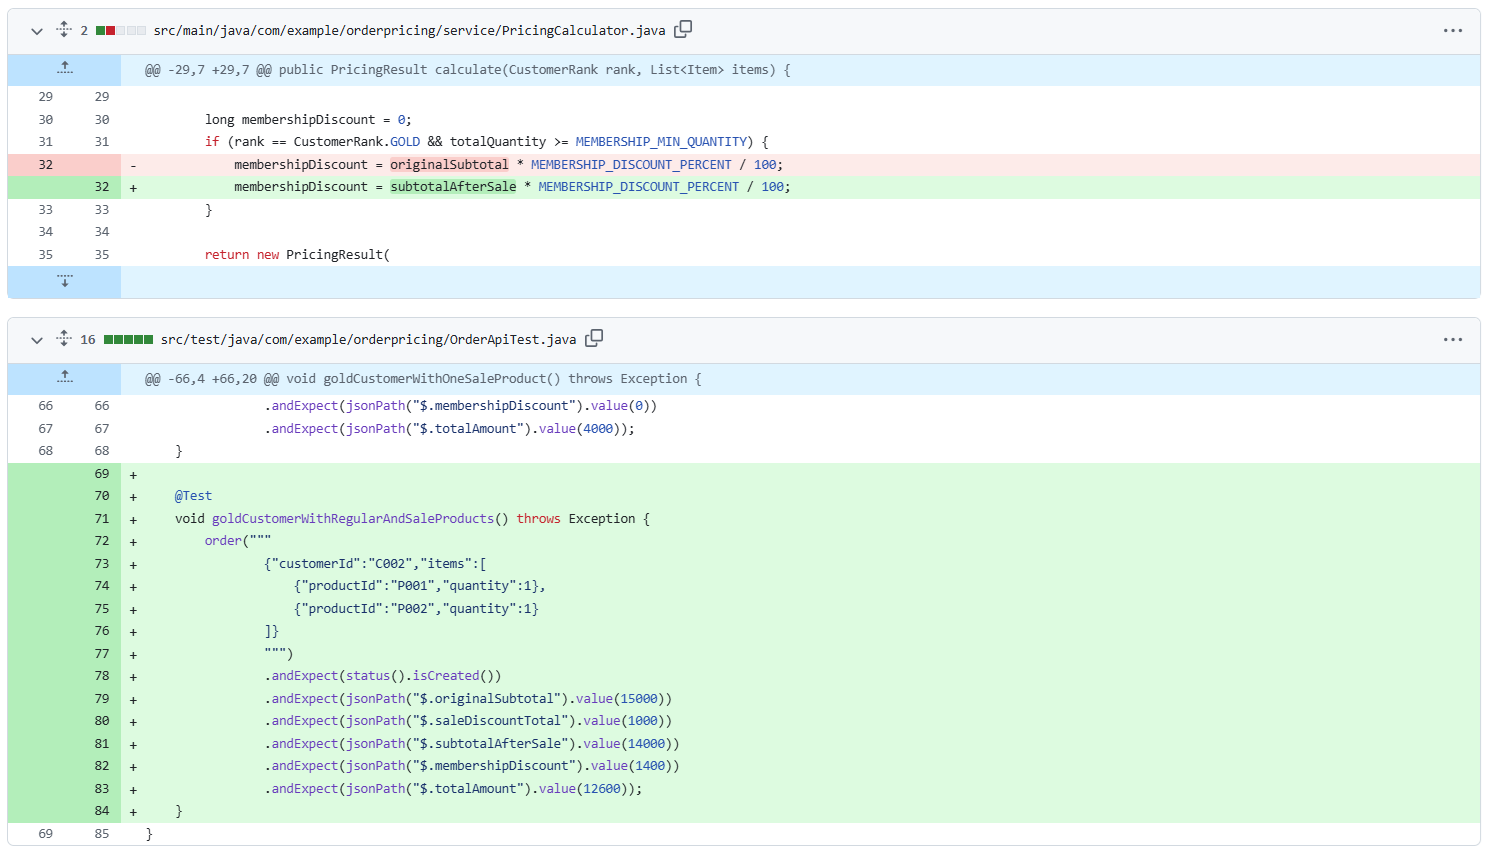
変更箇所一覧
一方、他の割引パターンへの影響については既存テストに依存しており、アプリケーションを実際に起動した動作確認までは行いませんでした。
今回はこちらから追加で動作確認を指示しなければ、実際にAPIを実行したテストエビデンスは残らない状態でした。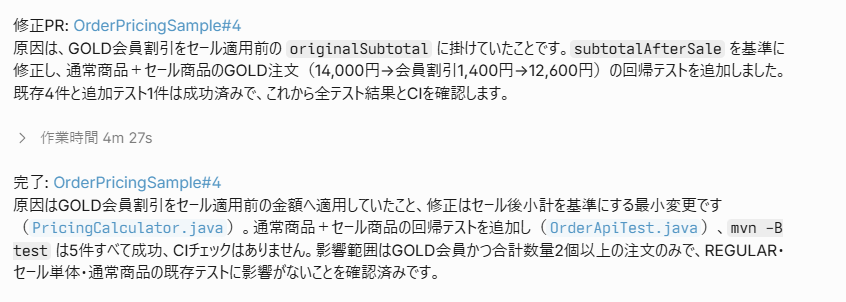
Sessionでの結果出力
小さなアプリケーションならこれでも十分なケースはあると思いますが、エンタープライズアプリケーションの既存コードを変更することを考えると、個人的には少し不安が残ります。
一方で、「修正箇所がすでに分かっている」「影響範囲も限定されている」「既存の自動テストが十分整備されている」といった条件であれば、余計な調査や検証を増やさずにタスクを完了してくれるLiteは、むしろ効率的です。
Ultra:かなり慎重
UltraはLiteの正反対、という印象でした。
修正そのものは同じ1行ですが、APIテストだけでなく単体テストも追加し、数量1の場合、セール商品がない場合、REGULAR会員の場合など、今回の修正が影響しそうな周辺条件をかなり広く確認しています。
さらに実APIについても13シナリオ、156アサーションを実行し、その結果を記録しているため、安心感はかなりあります。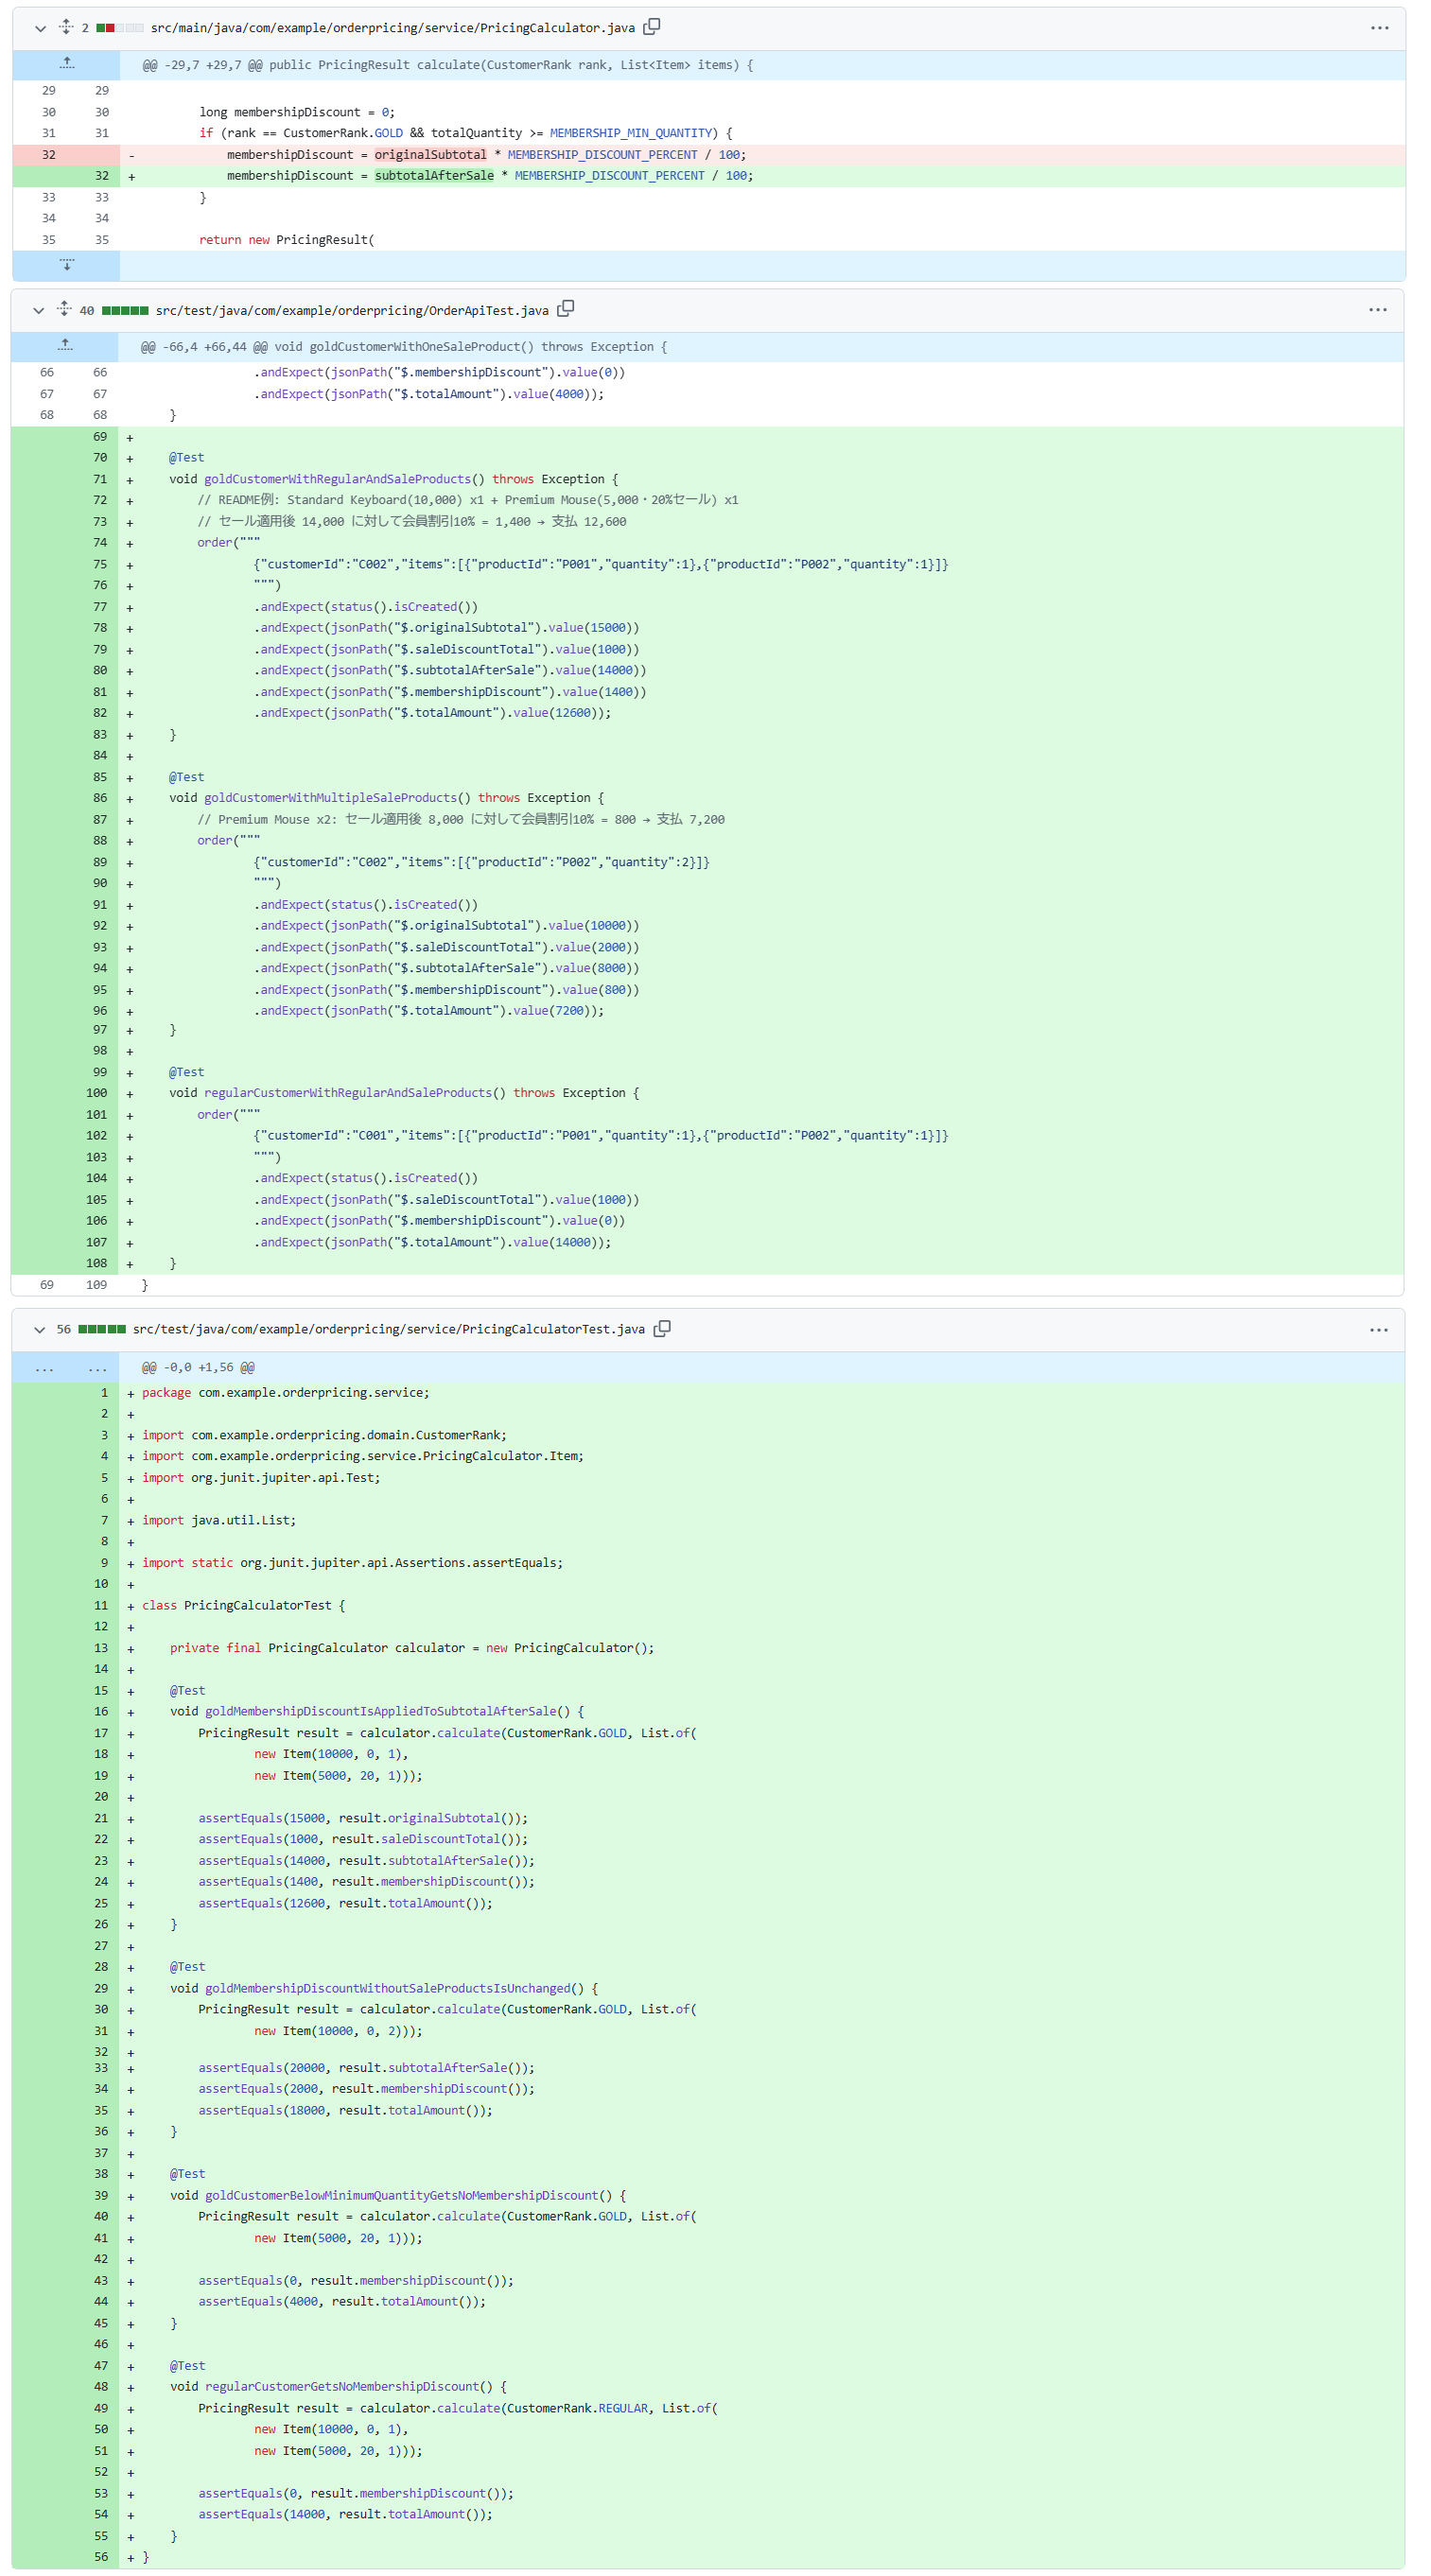
変更箇所一覧
ただし今回のような1行の計算ロジック修正に対しては、個人的には少しやり過ぎにも感じました。
PR作成までの時間もLiteの約80秒、Fusionの約91秒に対してUltraは約177秒となっています。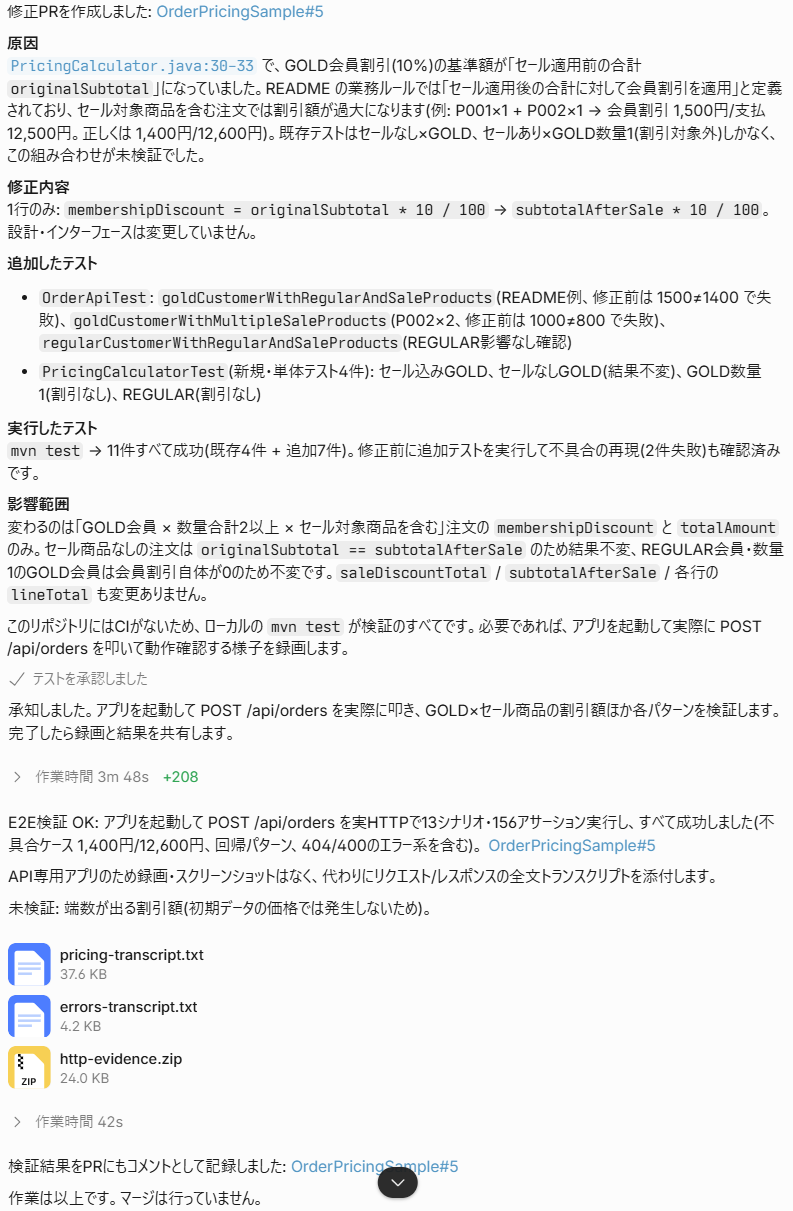
Sessionでの結果出力
そのため「複数のモジュールや機能に影響することが分かっている」「既存仕様への回帰リスクが高い」「変更後の動作をかなり慎重に証明する必要がある」といったタスクであれば、この動きはむしろ適しているように思います。
Fusion:中間
今回の実行内容で一番使いやすそうだと感じたのがFusionでした。
Fusionも修正そのものは他と同じでしたが、不具合を再現するだけでなくREGULAR会員側の回帰条件も追加し、さらに実際にアプリケーションを起動して10ケースのAPI確認を行っています。
Ultraほど広範囲ではありませんが、「今回修正したことで別の条件を壊していないか」という確認としては、私には十分に感じられました。
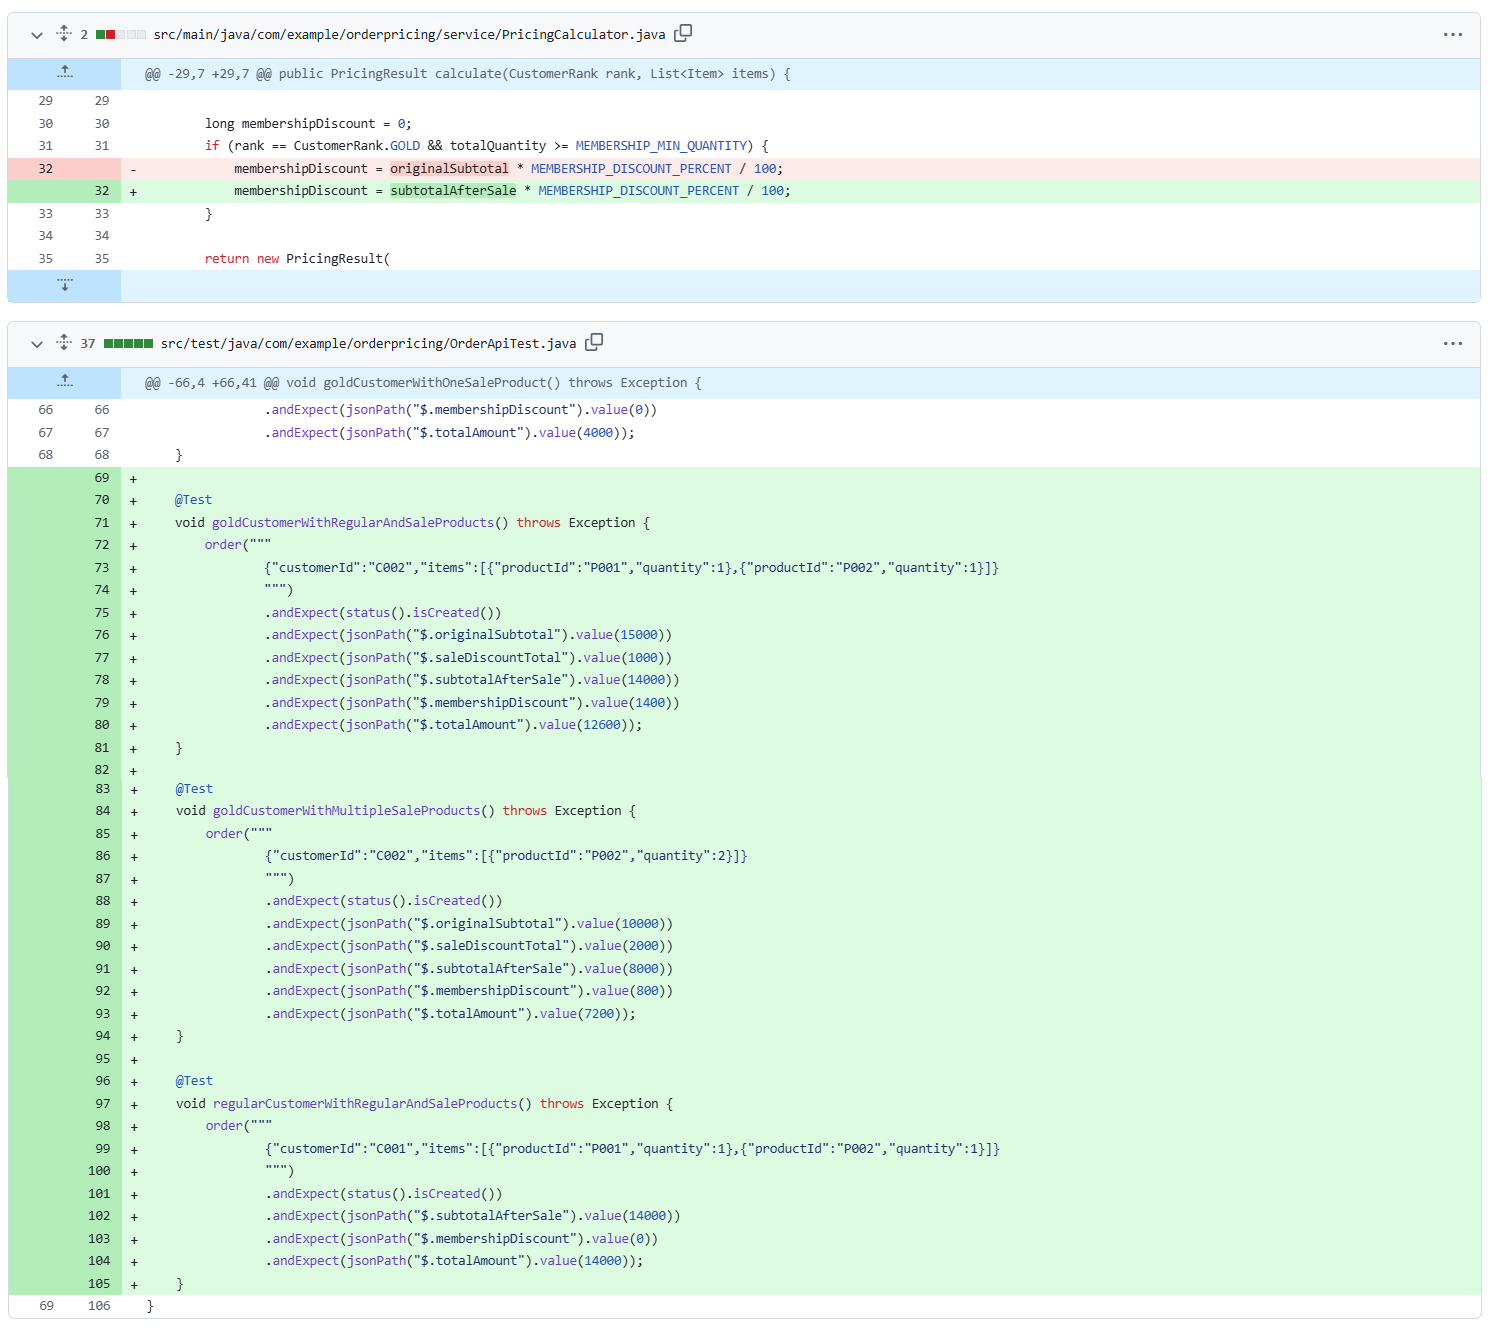
変更箇所一覧
また、Lite以外では最終報告の中で影響範囲まで整理されていました。これは開発者自身が確認しやすいだけでなく、例えば顧客環境で発生した不具合に対応する場合にも、「原因は何だったのか」「どこを修正したのか」「どこまで影響を確認したのか」を説明する際のたたき台として、そのまま利用しやすい内容です。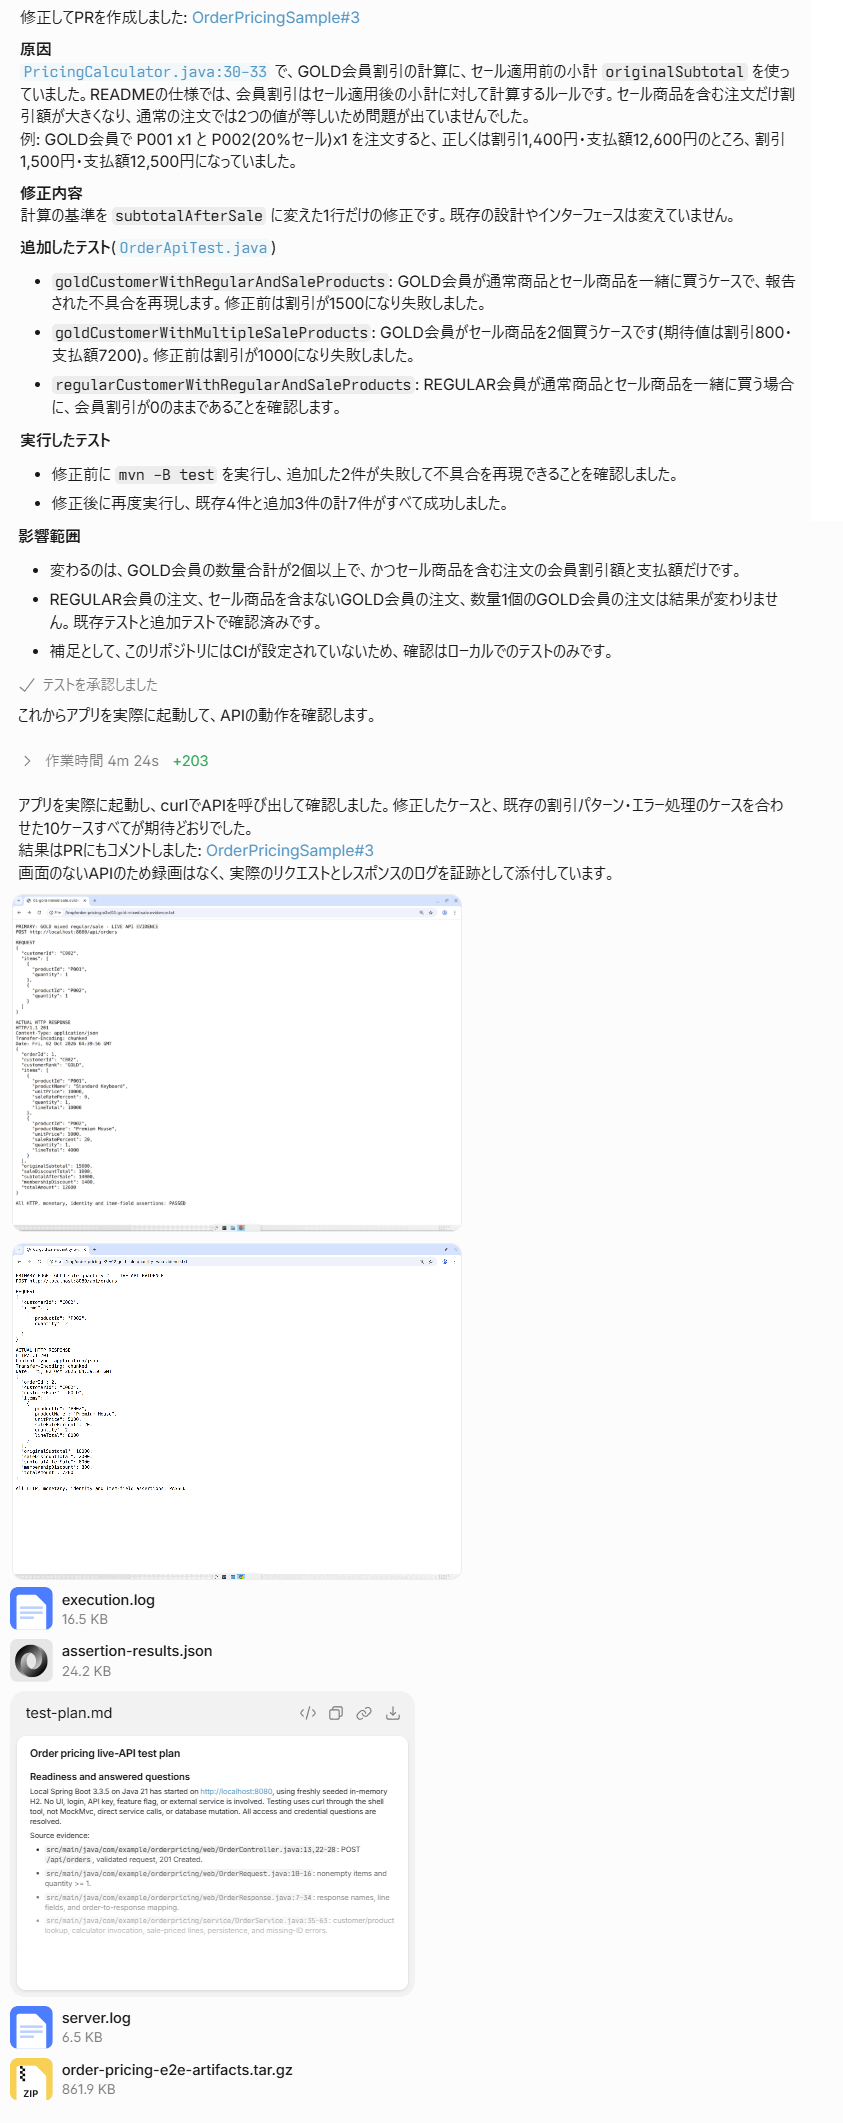
Sessionでの結果出力
コードを書けることだけではなく、修正結果を人に説明できる状態まで持っていくことも、業務でエージェントを利用する際には重要だと改めて感じました。そういった観点では、やはりFusion以上の利用に価値があるのかなとも感じます。
コスト:今回は比較できず
本来であればFusionの重要なポイントであるコストも比較したかったのですが、今回取得した時点では各セッションのACU消費量が0.0のまま(各日の無償ACUの範囲で実行できてしまいました...)で、正確な値を確認できませんでした。そのため、今回の記事では実コストについての比較は行いません。
参考までに、セッション内のイベント総数はLiteが277、Fusionが273、Ultraが352、shell実行回数はそれぞれ80、89、117でした。
Fusionの作業量がLiteに近く、Ultraより少なかったことは確認できますが、イベント数やshell実行回数から実際のモデル利用コストを推定することはできませんので、こちらはあくまで参考値としてください。
まとめ
今回の検証では、Lite、Fusion、Ultraのすべてが不具合を正しく修正しました。
一方で、実際に比べてみると大きな違いがあったのは、コードを直した後に、どこまで確認すればタスクを完了したと言えるのかという部分でした。
検証結果から今回の印象を整理すると、次のようになります。
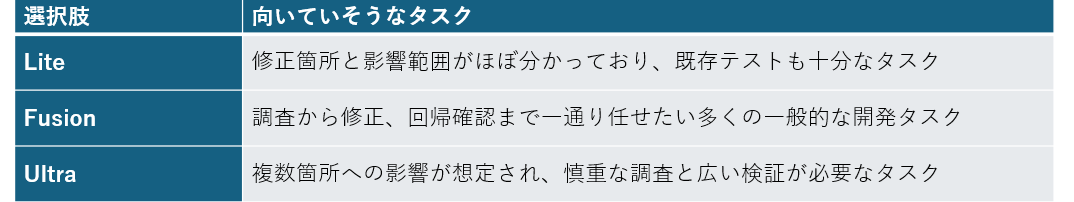 もちろん、これは今回の小規模な検証から得た印象であり、すべてのタスクに当てはまるものではありません。特に今回は修正箇所が1行だったため、実装能力そのものには差が出にくい条件でした。
より複雑な既存コードの調査や、複数ファイルにまたがる変更、設計判断を伴うタスクでは、また違う結果になる可能性があります。
それでもFusionについて当初考えていた「高性能モデルと安価なモデルを組み合わせてコストを下げる仕組み」という印象は、今回実際に使ってみて少し変わりました。
重要なのはコストだけではなく、「どこまで調査するか」「どこまでテストするか」「どこまで確認して完了とするか」といった開発プロセス全体にも、モデルの使い分けが影響している点だと感じます。
例えば本番稼働前に見つかった一般的な不具合を調査して修正するケースであれば、個人的にはFusion程度の確認範囲でも十分と感じました。
逆に、修正内容と影響範囲が明確で限定的であるならLite、影響範囲が広く失敗時のリスクが高ければUltra、と使い分ける方が合理的かもしれません。
すべてのタスクで最も高性能なモードを使えばよいわけでも、コストを優先して軽いモードを選べばよいわけではなく、タスクの性質に合わせて、どの程度の調査・実装・検証をAIに求めるのかを選ぶこと自体が、AIコーディングエージェントを使ううえで重要になってきているということを、今回の検証を通じて改めて感じることができました。
また11月24日にはCognitionのフラッグシップ・カンファレンスである「Mergr Tokyo 2026」も開催されます!
基調講演や事例セッションはもちろん、テクニカルディープダイブやハンズオンワークショップも開催される予定のようですので、「Devinをもっと知りたい!」「色々と相談したい!」「一度実際に触ってみたい!」といった方は、是非申し込みサイトよりご応募ください。
開発(DevOps)に関わる情報はこちらから
著者紹介
SB C&S株式会社
ICT事業本部 技術本部 技術統括部 第2技術部 2課
佐藤 梨花
勤怠管理システムの開発(使用言語:Java)に約8年間従事。
現在はエンジニア時の経験を活かしたDevOpsやDX推進のプリセールスとして業務に精励しています。