こんにちは。SB C&S の村上です。
この記事では、NVIDIA Dynamoが提供する推論最適化機能の1つである KV Cache-Aware Routing を実際に動かしながら、その仕組みや動作について紹介します。
第3回では、Frontendと複数のWorkerを構成し、1つのFrontendから複数Workerへ推論リクエストを振り分けるところまで確認しました。
一方でDynamoでは、デフォルトのルーティング方式としてRound-Robinが使用されるようになっています。そのため、第3回で構築した環境では、効率などは特に考慮せず、純粋に各Workerへ順番にリクエストを振り分けていました。
そこで今回は第3回の構成をベースに、各Workerが保持しているKV Cacheの状態とWorkerの負荷を考慮してリクエストの送信先を決定する「KV Cache-Aware Routing」を有効化します。
通常のRound-Robinによる振り分けと何が異なるのか、実際に動作を確認していきます。
なお、本記事は連載となっているため、第3回までの記事もあわせてご覧ください。
【連載①】NVIDIA Dynamo 紹介:概要編
【連載②】NVIDIA Dynamo 紹介:3つの最適化機能
【連載③】NVIDIA Dynamo 紹介:Dynamoを用いた推論の実行
【連載④】NVIDIA Dynamo 紹介:KV Cache-Aware Routingを用いたルーティング最適化←本記事
【連載⑤】NVIDIA Dynamo 紹介:Disaggregated Servingを用いた分散推論
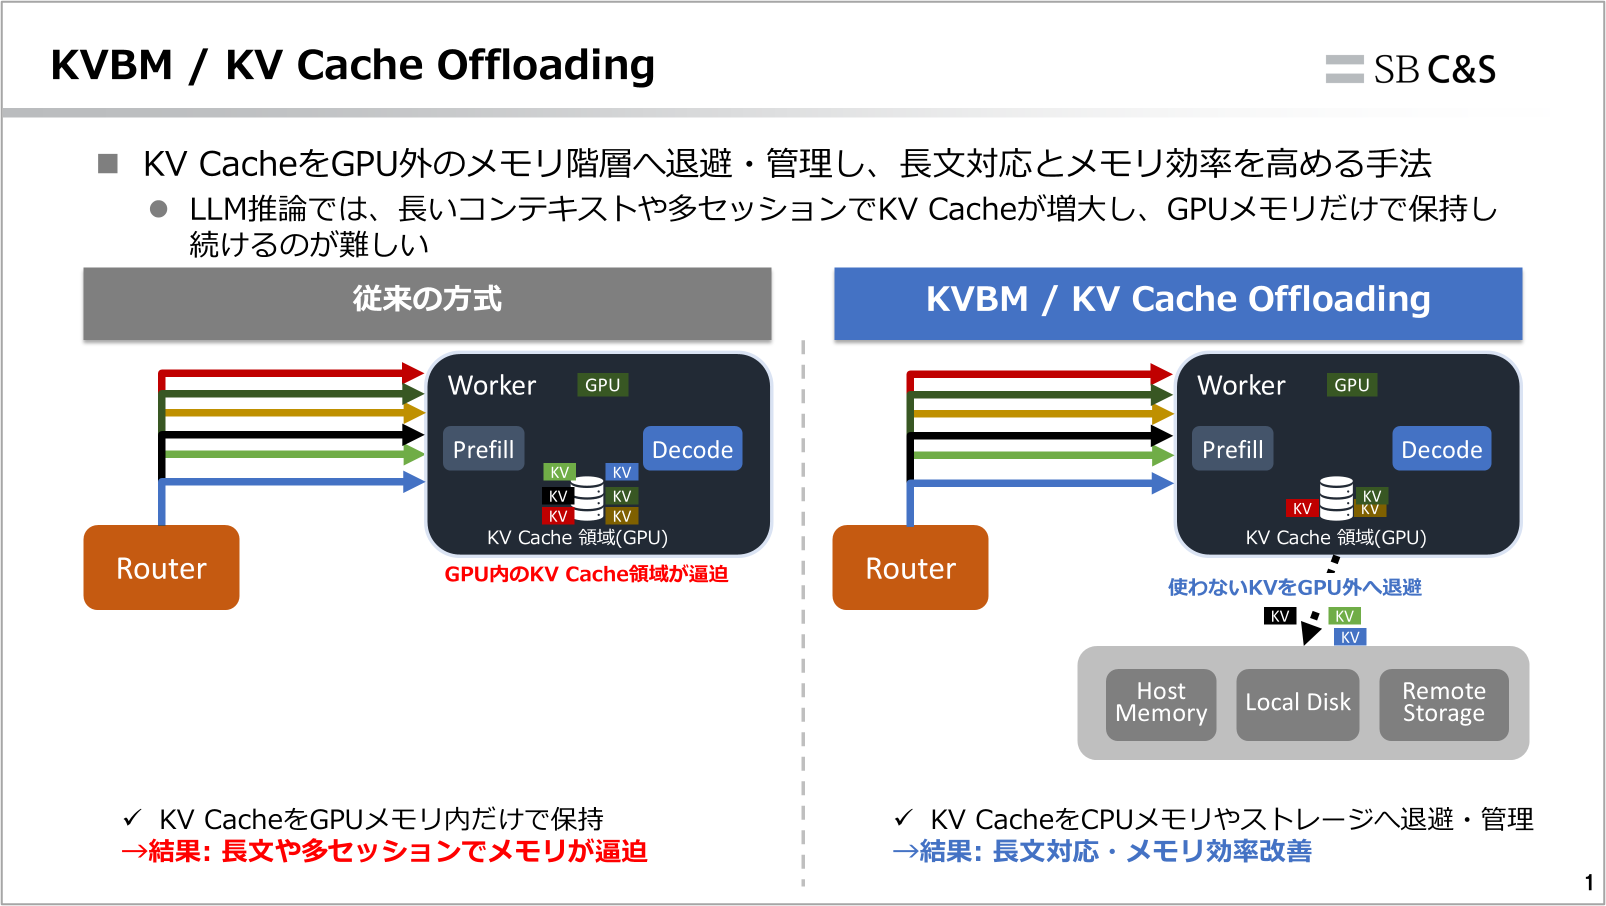
【連載⑥】NVIDIA Dynamo 紹介:KVBM / KV Cache Offloadingを用いたKVキャッシュの効率化
KV Cache-Aware Routingとは
第3回では、1つのFrontendに対して2台のWorkerを配置し、それぞれのWorkerを使い分けるように動作させました。
Frontendは受け取った推論リクエストをいずれかのWorkerへ振り分けますが、Dynamoのデフォルトでは Round-Robin が利用されます。
Round-Robinでは、Workerが保持しているKV Cacheの状態を考慮せず、利用可能なWorkerへ順番にリクエストを振り分けます。
一方、LLMの推論では、過去に処理したプロンプトと共通するPrefixのKV CacheがWorker上に残っていれば、その部分の計算結果を再利用できます。
例えば、以下の2つのリクエストを考えます。
1回目:
「日本の主要な観光地について詳しく説明してください。」
2回目:
「日本の主要な観光地について詳しく説明してください。
その中でも北海道について詳しく教えてください。」
2回目のリクエストには、1回目と共通するPrefixが含まれています。
1回目を処理したWorkerに該当するKV Cacheが残っている場合、同じWorkerへ2回目のリクエストを送ることで、共通部分のKV Cacheを再利用できる可能性があります。
ただし、別のWorkerへ送信された場合、そのWorkerには該当するKV Cacheが存在せず、共通部分についても再度Prefillの計算を行う必要があります。
そこでDynamoのKV Cache-Aware Routing では、各Workerが保持しているKV Cacheの情報をFrontend側で把握し、その情報とWorkerの負荷を考慮して、リクエストの送信先を決定します。
また、DynamoのKV Routerは、単純にKV Cacheの一致量だけでWorkerを選択するのではなく、PrefillやDecodeの負荷も考慮してWorkerを選択します。これにより、KV Cacheの再利用を狙いつつ、特定のWorkerへ処理が集中しすぎることを抑えます。
KV Cache-Aware Routingの仕組み
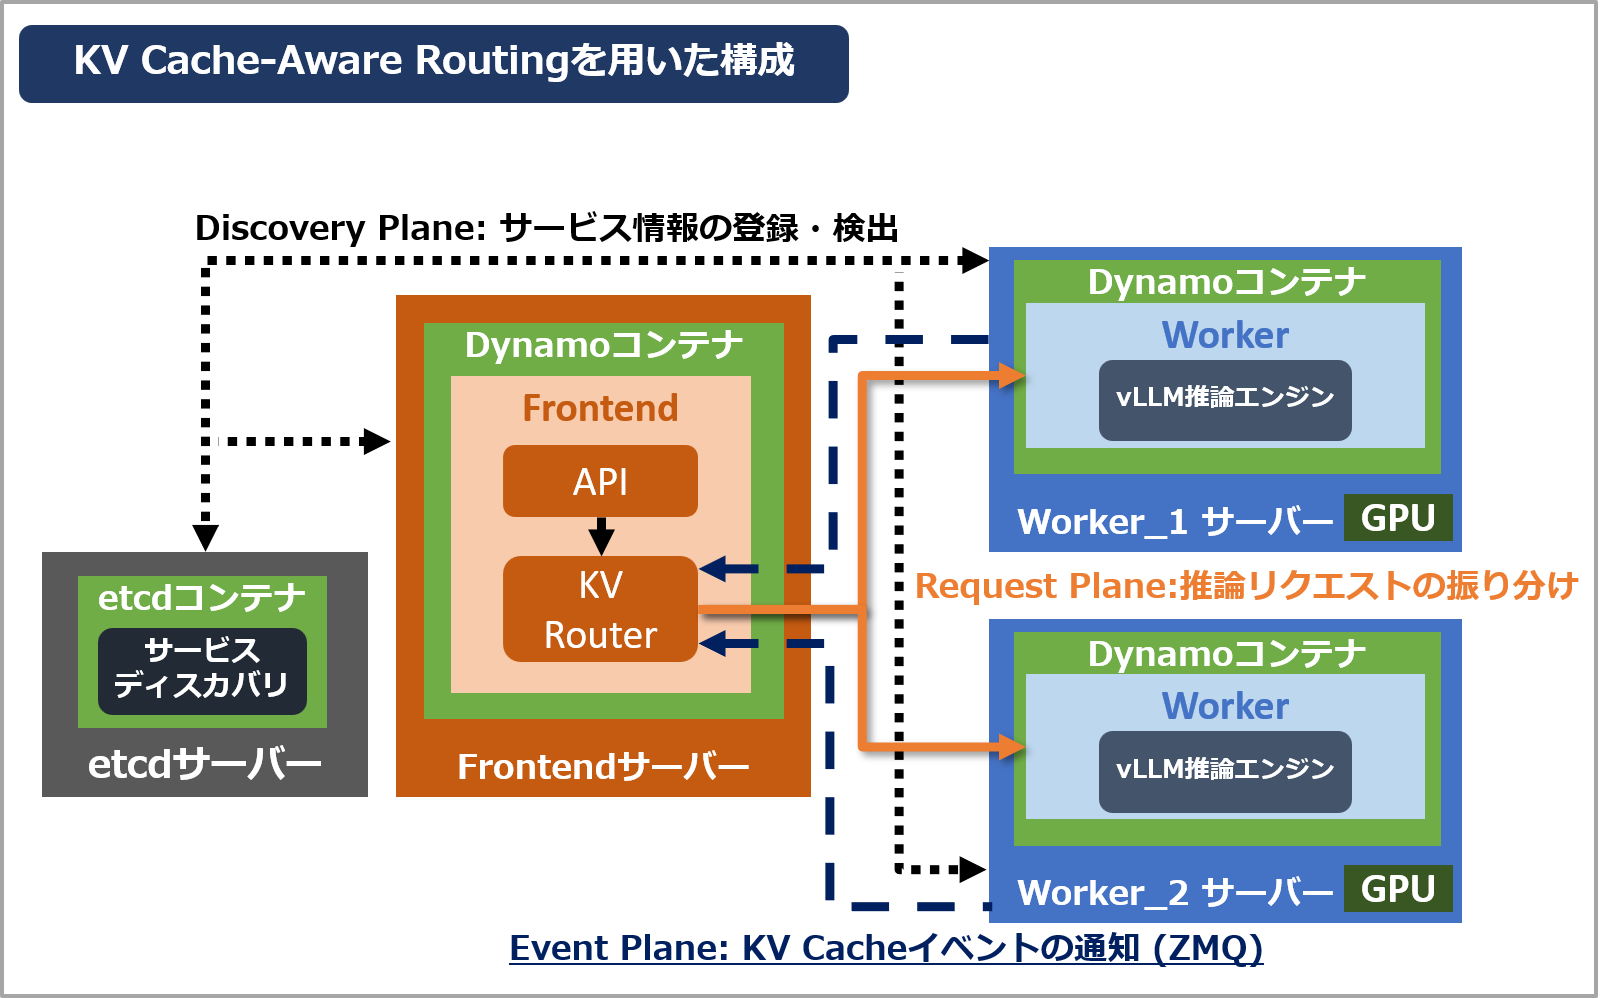
NVIDIA Dynamoでは、各コンポーネント間の通信を用途ごとに複数のPlaneとして分けています。
第3回でも利用したetcdによるサービス情報の登録・検出は Discovery Plane、FrontendからWorkerへ推論リクエストを送信する通信は Request Plane に該当します。
KV Cache-Aware Routingでは、これらに加えてKV Cacheの状態を通知するための Event Plane を利用します。
- Discovery Plane
- etcdを利用してWorkerのサービス情報を登録し、Frontendから検出
- Request Plane
- Frontendから選択したWorkerへ実際の推論リクエストを送信
- Event Plane
- WorkerからKV Cacheの作成・削除などのイベントを通知
今回の構成では、Event PlaneにはZMQを利用します。
ZMQ(ZeroMQ)は、プロセス間やノード間でメッセージをやり取りするための軽量なメッセージングライブラリです。一般的なメッセージブローカーのように専用のサーバーを必要とせず、各コンポーネント同士が直接通信できる点が特徴です。
WorkerではKV CacheのBlockが作成・削除されると、その情報をKV Cacheイベントとして発行します。
FrontendのKV RouterはEvent Planeを通じてこれらのイベントを受信し、
「どのWorkerにどのKV Cacheが存在するか」「リクエストのPrefixとどの程度重複しているか」
「各Workerが現在どの程度処理中か」といった情報をもとに、リクエストの送信先を選択します。
このように、KV Cache-Aware Routingでは「キャッシュを再利用できる場所」と「現在のWorkerの負荷」の両方を考慮してルーティングを行います。
環境準備
今回利用する環境は、第3回の複数Worker構成と同じです。
第3回では以下4台のサーバーを利用し、Frontendと2台のWorkerをetcdによるサービスディスカバリで連携しました。
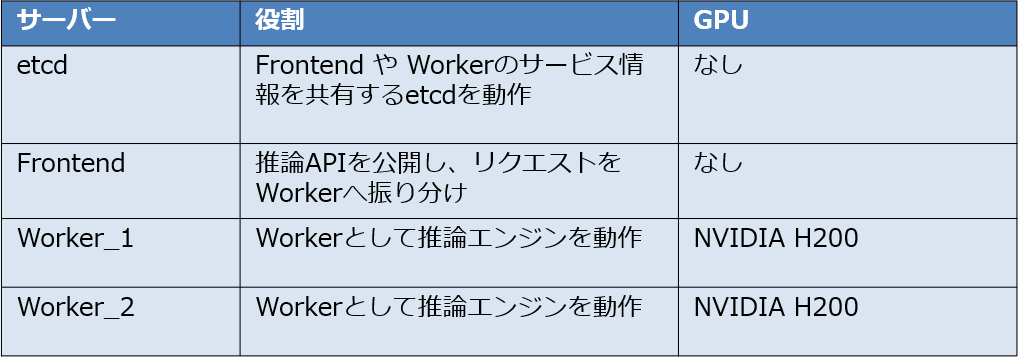
各サーバーのOSはUbuntu 24.04で、コンテナを実行できる状態まで準備済みとしています。
Workerを動作させるWorker_1およびWorker_2にはNVIDIA H200を搭載し、NVIDIA GPU DriverとNVIDIA Container Toolkitをインストール済みとしています。
コンテナイメージとしては、以下の2種類を利用します。
基本となるDynamoのコンテナイメージに加えて、複数Worker構成では、サービスディスカバリのためにetcdも使用します。なお、今回は推論エンジンに vLLM を用いるため、vLLM 用のコンテナイメージを使用します。
- Dynamo vLLM Runtime
- vLLMの推論エンジンを搭載したDynamoのコンテナイメージ
- nvcr.io/nvidia/ai-dynamo/vllm-runtime:1.4.0
- etcd
- 複数Worker構成におけるサービスディスカバリに使用
- quay.io/coreos/etcd:v3.5.14
利用するLLMに関しては事前にHugging FaceからQwen3-32Bをダウンロードして、マシン上の/opt/models配下に格納済みとなります。
https://huggingface.co/Qwen/Qwen3-32B
なお、以降の手順では各サーバーのIPアドレスを${ETCD_IP}、${FRONTEND_IP}、${WORKER1_IP}、${WORKER2_IP}のように表記します。
実行時には、それぞれ利用する環境のIPアドレスに読み替えてください。
KV Cache-Aware Routingを有効化した環境構築
それではKV Cache-Aware Routingを有効化したDynamo環境を構築していきます。
第3回で構築した複数Worker構成と多くの項目は同じになります。差分としては、KV Cache-Aware Routingを使うためのいくつかのオプションをコンテナ起動のタイミングに追加しています。
- FrontendでKV Routerを有効化
- WorkerがKV Cacheイベントを発行できるように設定
- Event PlaneにZMQを利用することを明示
etcdの起動
etcdについては第3回と同じ構成を利用します。
etcd用のサーバー上で以下コマンドを実行します。
docker run --rm -d \
  --name dynamo-etcd \
  --network host \
  quay.io/coreos/etcd:v3.5.14 \
  /usr/local/bin/etcd \
  --listen-client-urls=http://0.0.0.0:2379 \
  --advertise-client-urls=http://${ETCD_IP}:2379
起動後、以下コマンドでetcdの状態を確認し、trueが返答されれば準備完了です。
curl -s http://${ETCD_IP}:2379/health

## 出力
{"health":"true","reason":""}
Frontendの起動
続いてFrontendを起動します。
第3回の構成との大きな違いは、--router-mode kvとDYN_EVENT_PLANE=zmqを追加している点です。
docker run --rm -d \
  --name dynamo-frontend \
  --network host \
  -v /opt/models:/models:ro \
  -e ETCD_ENDPOINTS=http://${ETCD_IP}:2379 \
  -e DYN_REQUEST_PLANE=tcp \
  -e DYN_EVENT_PLANE=zmq \
  nvcr.io/nvidia/ai-dynamo/vllm-runtime:1.4.0 \
  python3 -m dynamo.frontend \
    --discovery-backend etcd \
    --model-name qwen3-32b \
    --model-path /models/Qwen3-32B \
    --http-port 8000 \
    --router-mode kv
追加した主な設定は以下となります。
- DYN_EVENT_PLANE=zmq
- KV Cacheイベントなどをやり取りするEvent PlaneにZMQを利用
- --router-mode kv
- デフォルトのRound-RobinからKV Cache-Aware Routingへ変更
第3回の構成との大きな違いは、KV Cache-Aware Routingを利用するために、--router-mode kvを指定している点です。
また、KV Cacheイベントの通知に利用するEvent Planeについても、通信方式を明示するため、DYN_EVENT_PLANE=zmqを指定しています。
※DYN_EVENT_PLANE=zmqはDynamo v1.4.0ではデフォルト値のため省略可能ですが、本記事ではコンポーネント間の通信方式を明確にする目的で、あえて指定しています。
Frontendが正常に起動したことを確認します。
curl -s http://${FRONTEND_IP}:8000/health | jq
Workerの起動
続いて、Worker_1とWorker_2にてWorkerとしてDynamoコンテナを起動します。
Worker_1とWorker_2それぞれ以下コマンドを実行します。
KV Cache-Aware Routingで各WorkerのKV Cacheの状態を利用するため、Worker側からKV Cacheイベントを発行する設定を追加しています。
docker run --rm -d \
  --name dynamo-worker \
  --gpus all \
  --ipc=host \
  --network host \
  -v /opt/models:/models:ro \
  -e ETCD_ENDPOINTS=http://${ETCD_IP}:2379 \
  -e DYN_SYSTEM_PORT=8081 \
  -e DYN_REQUEST_PLANE=tcp \
  -e DYN_EVENT_PLANE=zmq \
  -e PYTHONHASHSEED=0 \
  nvcr.io/nvidia/ai-dynamo/vllm-runtime:1.4.0 \
  python3 -m dynamo.vllm \
    --model /models/Qwen3-32B \
    --served-model-name qwen3-32b \
    --discovery-backend etcd \
    --block-size 64 \
    --dyn-reasoning-parser qwen3 \
    --kv-events-config '{"publisher":"zmq","topic":"kv-events","endpoint":"tcp://*:20080","enable_kv_cache_events":true}'
第3回から追加したWorker側の設定は以下となります。
- DYN_EVENT_PLANE=zmq
- WorkerからFrontendへKV Cacheイベントを通知するEvent PlaneにZMQを利用
- PYTHONHASHSEED=0
- KVイベントで利用するハッシュ値を決定的にし、Worker間で同じPrefixを同じ値として扱えるように設定
- --block-size 64
- KV Cacheを管理するBlock Sizeを指定
- モデルやワークロードなどで最適は変動
- 複数Workerで同じ値を利用
- --kv-events-config
- WorkerからKV Cacheイベントを発行するための設定
Frontend側の状態を確認し、Worker_1とWorker_2のWorkerが認識されていれば、準備完了です。
curl -s http://${FRONTEND_IP}:8000/health | jq
--kv-events-configについて
--kv-events-configは、vLLMで発生するKV Cacheの状態変化をイベントとして外部へ発行するための設定です。
このオプション自体はDynamo独自のものではなく、vLLMが提供するネイティブの設定となります。Dynamoではこの機能を利用して、各WorkerのKV Cache情報をFrontendのKV Routerへ伝えます。
今回指定している設定は以下となります。
- publisher
- KV Cacheイベントの発行方式を指定。今回はZMQを利用
- topic
- KV Cacheイベントを識別するTopic名
- endpoint
- ZMQでKV CacheイベントをPublishする待ち受けアドレス
- enable_kv_cache_events
- KV Cacheイベントの発行を有効化
この設定によって、Worker上でKV Cache Blockの保存・削除などの状態変化が発生すると、その情報がKV Cacheイベントとして発行されます。
FrontendのKV RouterはEvent Planeを通じてこれらのイベントを受信し、各Workerが保持しているKV Cacheの状態を追跡します。
なお、--kv-events-configの各パラメータはvLLM側の設定となるため、詳細についてはvLLM公式ドキュメントを参照してください。
https://docs.vllm.ai/en/stable/api/vllm/config/kv_events/
KV Cache-Aware Routingの挙動確認
それでは、KV Cache-Aware Routingによってリクエストの振り分けがどのように変化するのか確認します。
今回は、同一の長めのプロンプトを10回連続して送信し、各Workerへのリクエストの振り分けを確認します。
今回は以下のような長めのプロンプトを変数にいれて準備します。
PROMPT="日本語で回答をお願いします。
Qwen3について教えてください。
私はLLMの基本的な仕組みはある程度知っていますが、Qwen3のモデル構成については詳しくありません。
Qwen3-32Bがどのようなモデルなのか、モデルアーキテクチャやパラメータ規模、推論時の特徴などを含めて分かりやすく説明してください。
また、他のモデルと比較してどのような特徴があるのかも教えてください。"
それでは10回プロンプトを繰り返しで投げます。
for i in $(seq 1 10); do
  curl -s http://${FRONTEND_IP}:8000/v1/chat/completions \
    -H "Content-Type: application/json" \
    -d "{
      \"model\": \"qwen3-32b\",
      \"messages\": [
        {
          \"role\": \"user\",
          \"content\": \"${PROMPT}\"
        }
      ],
      \"max_tokens\": 1024
    }" | jq
done
"
実行結果を確認すると、10回のリクエストはすべてWorker_2で処理され、同一プロンプトに対して特定のWorkerが継続して選択される様子を確認できました。
第3回のRound Robinでは、10回のリクエストがWorker_1とWorker_2へ5回ずつ均等に振り分けられました。一方、今回のKV Cache-Aware Routingでは10回すべてがWorker_2へ振り分けられ、Round-Robinとは異なる振り分けになっていることが分かります。
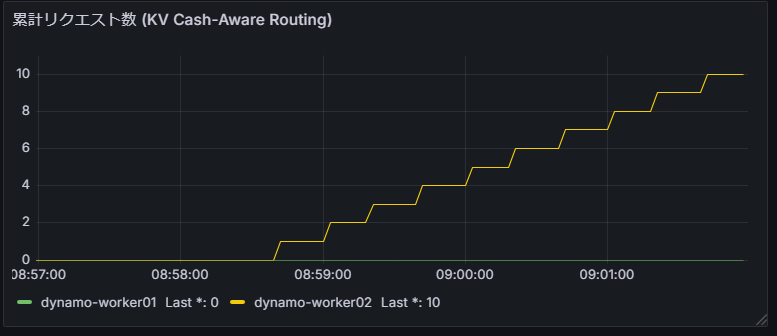
動作としては、最初のリクエストを処理したWorker_02には対応するKV Cacheが保持されるため、後続のリクエストでもそのKV Cacheを再利用しやすくなります。
DynamoのKV Routerは、各Workerが保持しているKV CacheとのPrefixの重複状況と現在の負荷をもとに送信先を決定します。今回の検証では、KV Cacheを保持しているWorker_2が継続して選択され、KV Cache-Aware Routingによる振り分けの特徴を分かりやすく確認することができました。
なお、KV Cacheの再利用性だけでなくWorkerの負荷も考慮されるため、状況によっては別のWorkerが選択される場合もあります。
まとめ
本記事では、NVIDIA DynamoのKV Cache-Aware Routingを実際に構成し、リクエストルーティングの動作を確認しました。
KV Cache-Aware Routingを利用することで、各Workerが保持しているKV Cacheの状態と現在の負荷をもとに、推論リクエストの送信先を決定できます。
これにより、Round-Robinのように単純にリクエストを振り分けるのではなく、既存のKV Cacheを再利用できるWorkerへリクエストを送信し、推論処理を効率化できます。
次回は分散推論機能のDisaggregated Servingについて紹介します。
【連載⑤】NVIDIA Dynamo 紹介:Disaggregated Servingを用いた分散推論
NVIDIAに関する情報発信はこちら
著者紹介
SB C&S株式会社
ICT事業本部 技術本部 第1技術統括部
第2技術部 1課
村上 正弥 - Seiya.Murakami -
VMware vExpert