こんにちは。SB C&S の村上です。
この記事では、NVIDIA Dynamo が提供する推論最適化機能の1つである「Disaggregated Serving」を実際に構成し、仕組みや動作について紹介します。
なお、本記事は連載となっているため、第4回までの記事もあわせてご覧ください。
【連載①】NVIDIA Dynamo 紹介:概要編
【連載②】NVIDIA Dynamo 紹介:3つの最適化機能
【連載③】NVIDIA Dynamo 紹介:Dynamoを用いた推論の実行
【連載④】NVIDIA Dynamo 紹介:KV Cache-Aware Routingを用いたルーティング最適化
【連載⑤】NVIDIA Dynamo 紹介:Disaggregated Servingを用いた分散推論←本記事
【連載⑥】NVIDIA Dynamo 紹介:KVBM / KV Cache Offloadingを用いたKVキャッシュの効率化
Disaggregated Servingとは
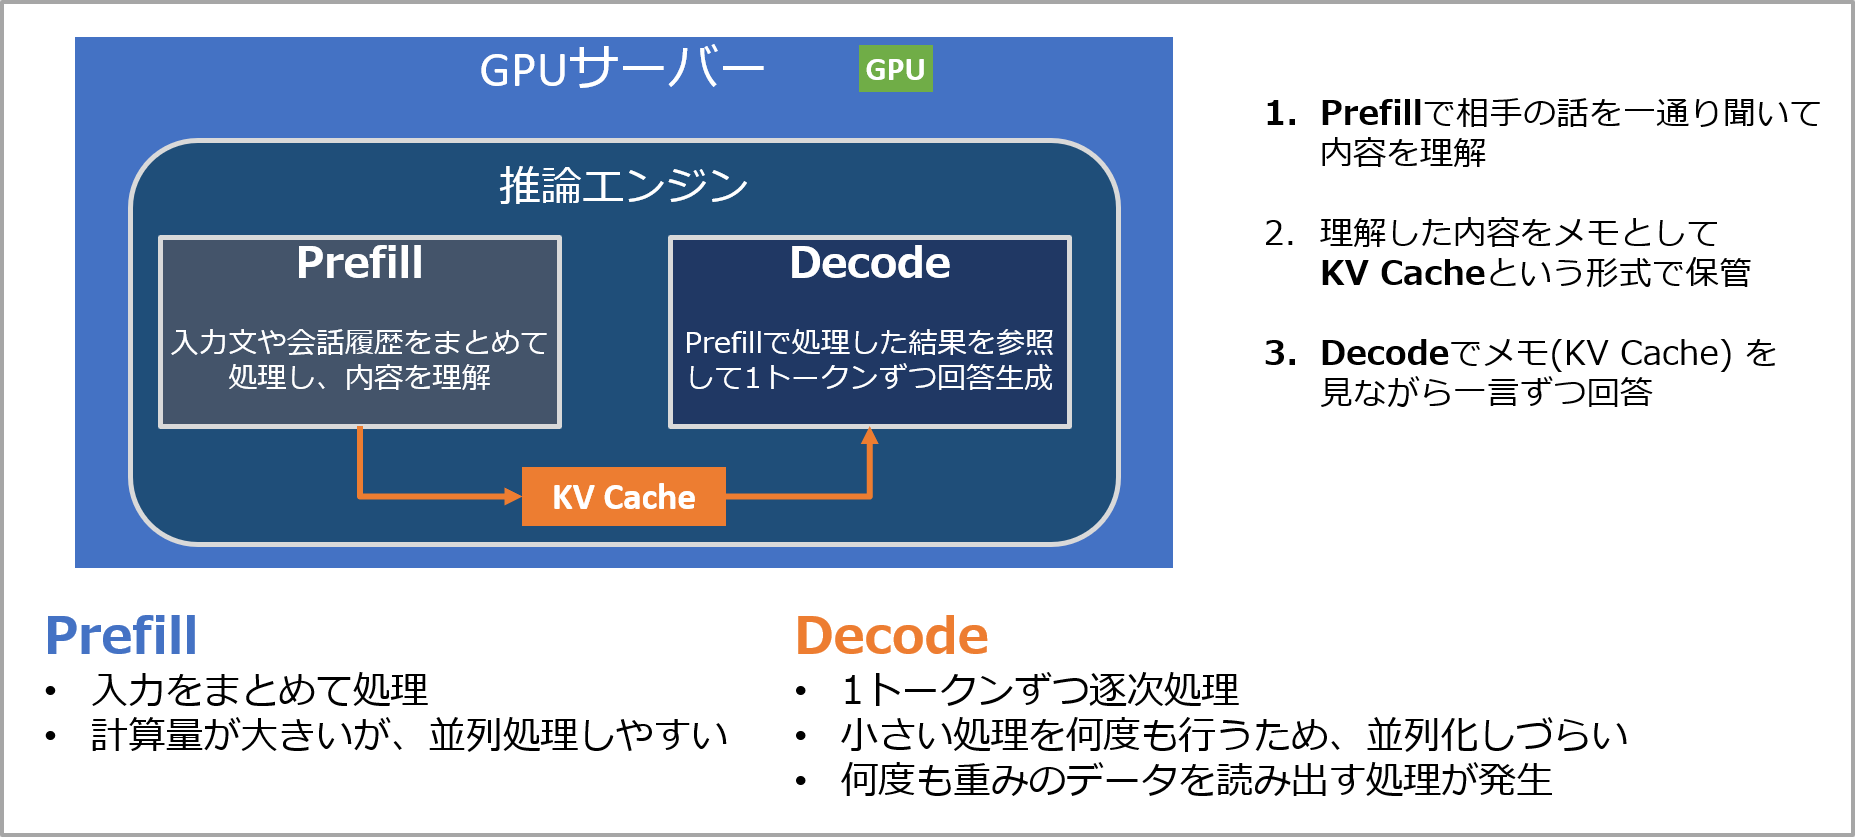
まず、LLMの推論処理は、大きくPrefillとDecodeの2つの処理に分けることができます。
初めにユーザーから送られてきたプロンプト全体を読み込んで文脈理解などの初期計算を行うPrefillが行われ、その結果としてKV Cacheが構築されます。そして、実際に回答となるTokenを生成するDecodeの処理が行われます。
イメージとしては、会話をする時に相手の話を聞いて内容を理解するのがPrefillで、その際に理解した内容のメモがKV Cacheで、話を聞いた上での発言がDecodeのようなイメージです。
なお、このPrefillとDecodeでは処理の特性が大きく異なります。
Prefillでは、入力された多数のTokenをまとめて処理するため計算量は大きくなりますが、Tokenを並列に処理しやすく、GPUの演算性能を活用しやすい処理となります。
一方、Decodeでは回答となるTokenを1つずつ生成します。次のTokenを生成するためには、それまでに生成した結果を利用する必要があるため、Prefillと比べて逐次的な処理となります。また、Tokenを生成するたびにKV Cacheやモデルの重みを繰り返し参照するため、GPUのメモリ帯域の影響も受けやすい処理となります。
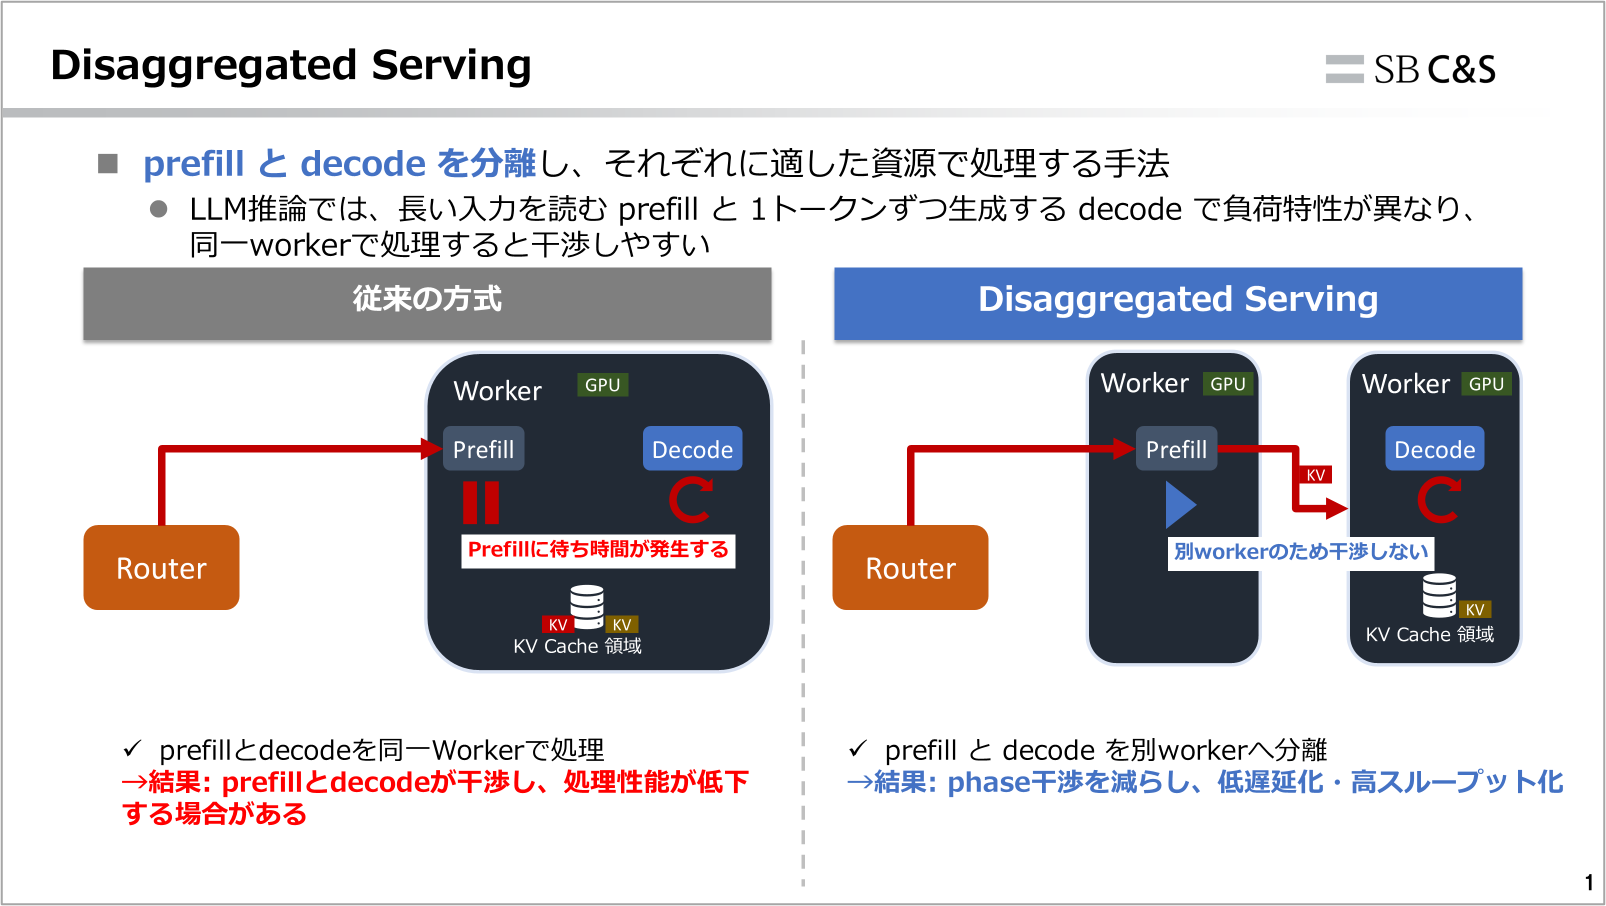
従来は、これら2つの処理を同じWorker上で実行することが一般的です。第3回および第4回で利用した構成も、1つのvLLM推論エンジンの中でPrefillとDecodeの両方を処理していました。
しかしその場合、どちらかの処理が遅れている場合にもう片方の処理にも遅れが発生する場合があります。
そこでDynamoのDisaggregated Servingは、LLM推論を単一の処理としてまとめて扱うのではなく、PrefillとDecodeを別々のWorkerに分離して実行させることで最適化します。これにより、お互いの処理が干渉しにくくなり、それぞれの処理特性に応じてリソースの使い分けを最適化できます。
フェーズ間の干渉が減ることでDecode側はトークン生成に集中しやすくなり、低遅延化が期待できます。また、Prefill側もまとまった入力処理に専念できるため、システム全体としてのスループット向上も期待できます。
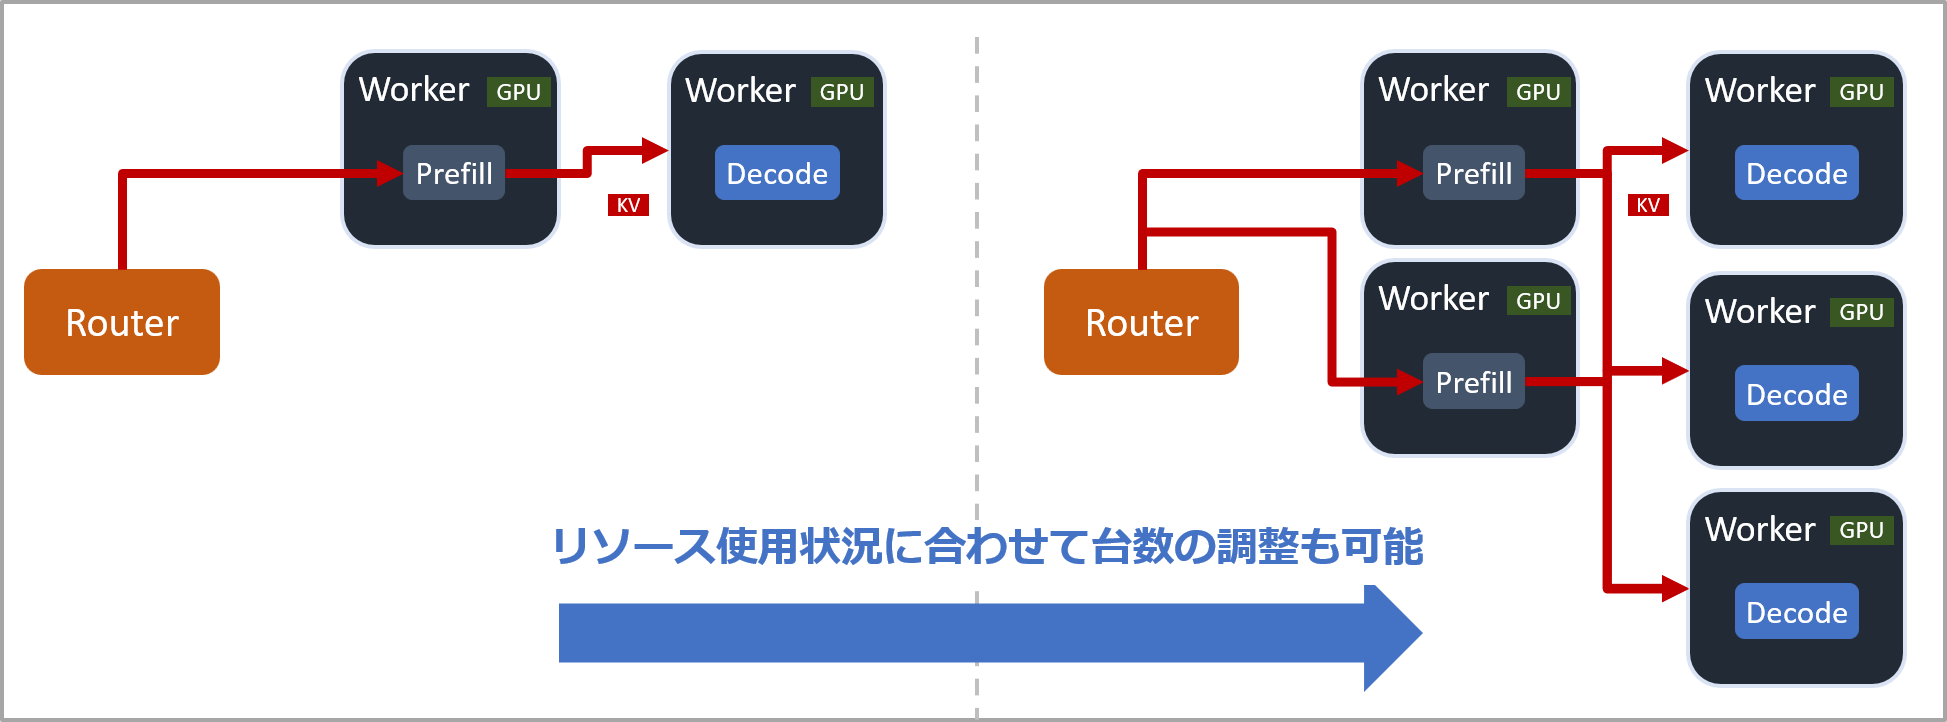
また、PrefillとDecodeを分けることにより、どちらかのGPUリソースが不足した場合も、負荷の高い方のWorkerを増やすことで、個別にスケールできるようになります
Disaggregated Servingの仕組み
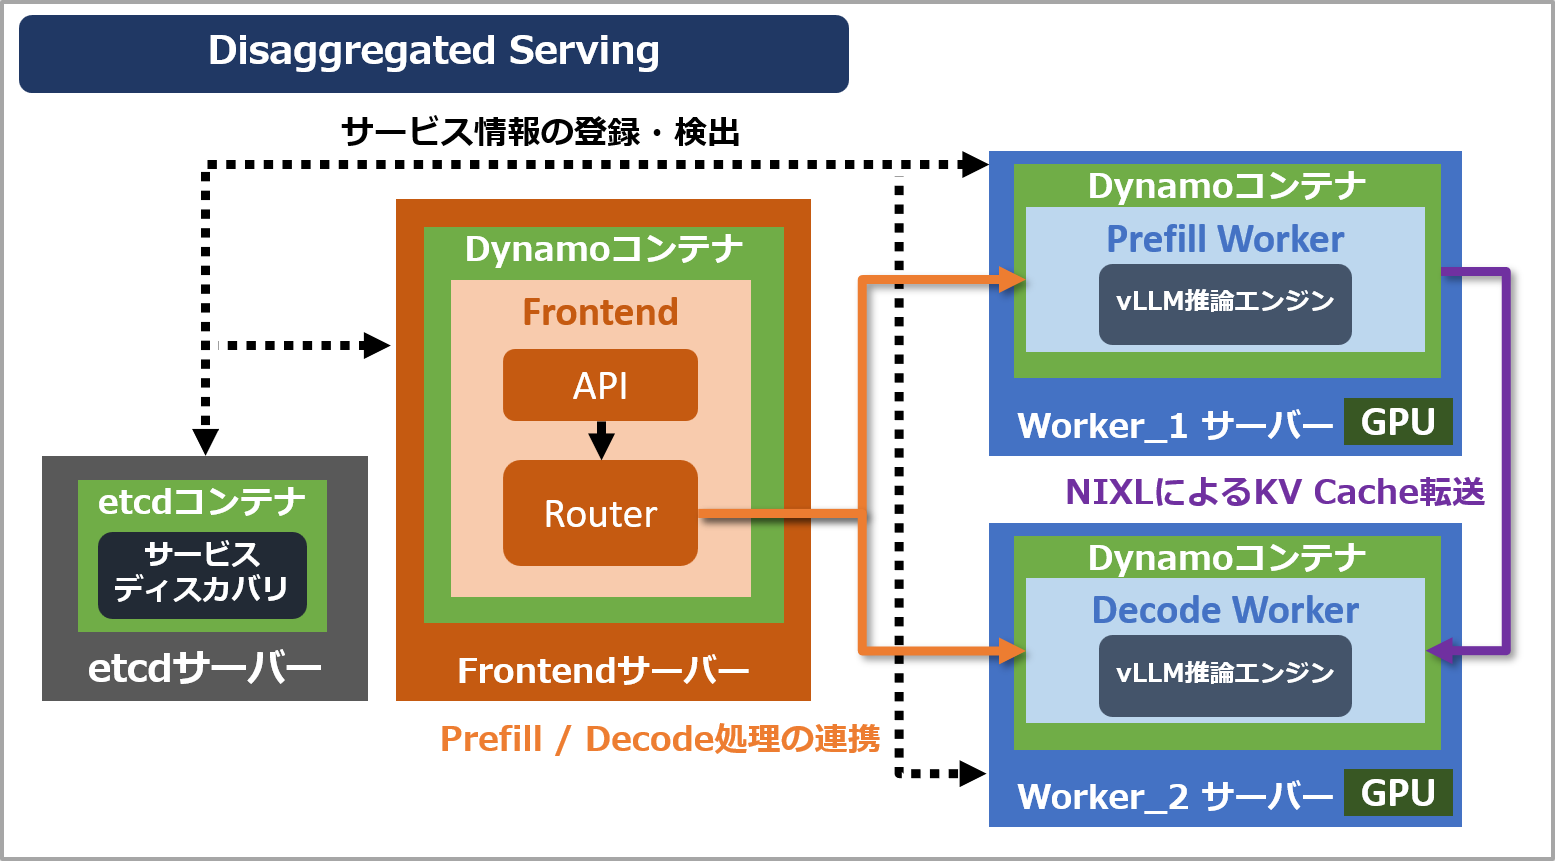
Disaggregated Servingでは、PrefillとDecodeを別々のGPU上で実行します。
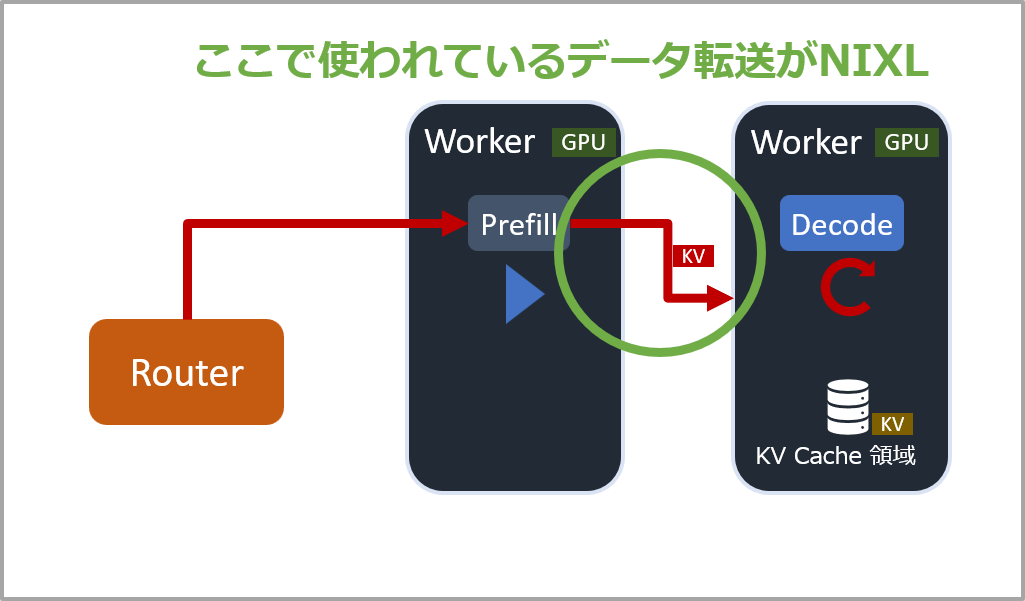
そのため、Prefill Workerでプロンプトを処理した後、その計算結果であるKV CacheをDecode Workerへ渡す必要があります。
このKV Cache転送にNIXL(NVIDIA Inference Xfer Library)というライブラリを利用しています。
NIXLは、GPUメモリ間でKV Cacheなどの推論データを効率的に転送するためのライブラリです。
Disaggregated Servingでは、NIXLを利用してPrefill Workerが生成したKV CacheをDecode WorkerのGPUメモリへ転送します。DynamoではKV Cacheの転送をノンブロッキングで行えるようになっており、転送中もGPUは他のリクエストに対する処理を継続可能です。
今回のようにPrefill WorkerとDecode Workerを別サーバーに配置する場合には、ネットワークを経由してKV Cacheを転送します。
そのため、実際に大規模なDisaggregated Serving環境を構築する場合には、GPUだけでなくWorker間のネットワーク帯域も重要です。
環境準備
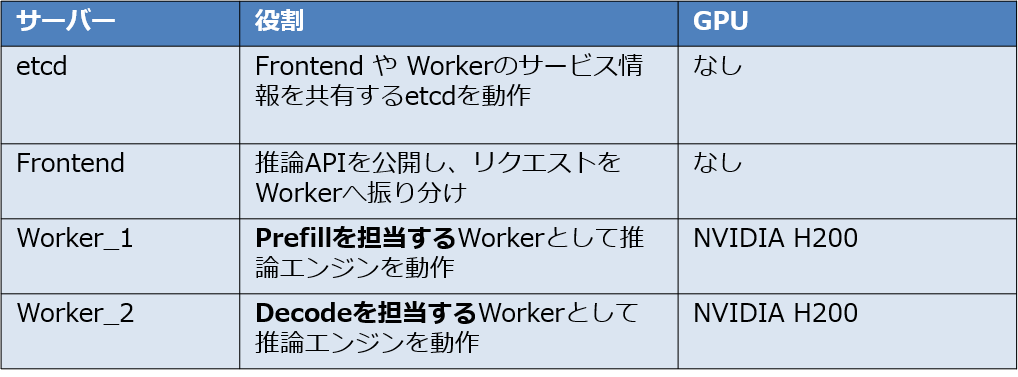
今回利用する環境は、第3回および第4回と同じ4台構成です。
第3回および第4回では、Worker_1とWorker_2の両方でPrefillとDecodeを実行するWorkerとして動作させていました。
一方で今回はWorker_1をPrefill専用、Worker_2をDecode専用として動作させます。
各サーバーのOSはUbuntu 24.04で、コンテナを実行できる状態まで準備済みとしています。
Worker_1およびWorker_2にはNVIDIA H200を搭載し、NVIDIA GPU DriverとNVIDIA Container Toolkitをインストール済みとしています。
コンテナイメージとしては、以下の2種類を利用します。
基本となるDynamoのコンテナイメージに加えて、複数Worker構成では、サービスディスカバリのためにetcdも使用します。なお、今回は推論エンジンに vLLM を用いるため、vLLM 用のコンテナイメージを使用します。
- Dynamo vLLM Runtime
- vLLMの推論エンジンを搭載したDynamoのコンテナイメージ
- nvcr.io/nvidia/ai-dynamo/vllm-runtime:1.4.0
- etcd
- 複数Worker構成におけるサービスディスカバリに使用
- quay.io/coreos/etcd:v3.5.14
利用するLLMに関しては事前にHugging FaceからQwen3-32Bをダウンロードして、マシン上の/opt/models配下に格納済みとなります。
https://huggingface.co/Qwen/Qwen3-32B
なお、以降の手順では各サーバーのIPアドレスを${ETCD_IP}、${FRONTEND_IP}、${WORKER1_IP}、${WORKER2_IP}のように表記します。
実行時には、それぞれ利用する環境のIPアドレスに読み替えてください。
Disaggregated Serving環境の構築
それでは、Disaggregated Servingを利用した推論環境を構築していきます。
基本的な構成は、第3回で構築した複数Worker構成と同様です。
差分として、第3回ではWorker_1とWorker_2の両方でPrefillとDecodeを実行するWorkerを起動しましたが、今回はそれぞれのWorkerに役割を分け、Worker_1をPrefill専用、Worker_2をDecode専用として起動します。
- WorkerごとにPrefill / Decodeの役割を指定
- Prefill WorkerとDecode Worker間のKV Cache転送を有効化
etcdの起動
etcdについては第3回と同じ構成を利用します。
etcd用のサーバー上で以下コマンドを実行します。
docker run --rm -d \
  --name dynamo-etcd \
  --network host \
  quay.io/coreos/etcd:v3.5.14 \
  /usr/local/bin/etcd \
  --listen-client-urls=http://0.0.0.0:2379 \
  --advertise-client-urls=http://${ETCD_IP}:2379
起動後、以下コマンドでetcdの状態を確認し、trueが返答されれば準備完了です。
curl -s http://${ETCD_IP}:2379/health

## 出力
{"health":"true","reason":""}
Frontendの起動
続いてFrontendを起動します。
Frontendに関しては、Disaggregated Serving固有の設定はなく、純粋に起動を行えば問題ないです。
※今回はDisaggregated Servingそのものの動作確認に焦点を当てるため、第4回で利用したKV Cache-Aware Routingは有効化していません
docker run --rm -d \
  --name dynamo-frontend \
  --network host \
  -v /opt/models:/models:ro \
  -e ETCD_ENDPOINTS=http://${ETCD_IP}:2379 \
  -e DYN_REQUEST_PLANE=tcp \
  nvcr.io/nvidia/ai-dynamo/vllm-runtime:1.4.0 \
  python3 -m dynamo.frontend \
    --discovery-backend etcd \
    --model-name qwen3-32b \
    --model-path /models/Qwen3-32B \
    --http-port 8000
Frontendが正常に起動したことを確認します。
curl -s http://${FRONTEND_IP}:8000/health | jq
Prefill用Workerを起動
続いて、Worker_1上でPrefillを担当するWorkerを起動します。
第3回のWorkerとの主な違いは、Disaggregated Servingを利用するために、Prefill Workerとして動作する設定とKV CacheをDecode Workerへ転送する設定を追加している点です。
docker run --rm -d \
  --name dynamo-prefill \
  --gpus all \
  --ipc=host \
  --network host \
  -v /opt/models:/models:ro \
  -e ETCD_ENDPOINTS=http://${ETCD_IP}:2379 \
  -e DYN_SYSTEM_PORT=8081 \
  -e DYN_REQUEST_PLANE=tcp \
  -e VLLM_NIXL_SIDE_CHANNEL_PORT=20001 \
  nvcr.io/nvidia/ai-dynamo/vllm-runtime:1.4.0 \
  python3 -m dynamo.vllm \
    --model /models/Qwen3-32B \
    --served-model-name qwen3-32b \
    --discovery-backend etcd \
    --max-model-len 40960 \
    --block-size 64 \
    --disaggregation-mode prefill \
    --dyn-reasoning-parser qwen3 \
    --kv-transfer-config \
      '{"kv_connector":"NixlConnector","kv_role":"kv_producer"}'
Disaggregated Servingを利用するために追加したWorker側の設定は以下となります。
- --disaggregation-mode prefill
- WorkerをDisaggregated ServingにおけるPrefill Workerとして動作させる
- --kv-transfer-config
- Prefill WorkerとDecode Worker間でKV Cacheを転送するための設定
- kv_connectorには、KV Cache転送にNIXLを利用するNixlConnectorを指定
- kv_roleはKV Cache転送における役割を定義する設定であり、Prefill WorkerではKV Cacheを生成・提供する側としてkv_producerを指定
- VLLM_NIXL_SIDE_CHANNEL_PORT=20001
- NIXL ConnectorがWorker間で接続情報などをやり取りするために利用するポート
- --block-size 64
- KV Cacheを管理するBlock Sizeを指定
- Block SizeはKV Cacheの転送効率やPrefix Cacheの再利用効率に影響し、小さい値では細かい単位でKV Cacheを再利用しやすくなる一方、大きい値ではKV Cacheの転送効率が向上する場合がある
- Dynamoの公式ドキュメントでは、Disaggregated ServingにおけるBlock Sizeのチューニング開始値として128が推奨されています。ただし、最適な値は利用する推論エンジンやモデル、ワークロードによって異なる
- Prefill WorkerとDecode Worker間でKV Cacheを受け渡すため、両Workerで同じBlock Sizeを指定
Decode Workerでは、Prefill Workerが生成したKV Cacheを受け取って利用するため、kv_roleにkv_consumerを指定します。
なお、NixlConnectorでは従来利用されていたkv_bothが新しいvLLMで非推奨となっているため、Prefill WorkerとDecode Workerでそれぞれの役割を明示しています。
KV Cache転送に利用するConnectorの種類やバージョンによって必要な設定は異なるため、実際の構築時には利用するConnectorに対応した設定を確認してください。
Decode用Workerを起動
最後にWorker_2上でDecodeを担当するWorkerを起動します。
前述のPrefill用Workerと起動コマンドはほとんど同じですが、--disaggregation-modeにはdecodeを指定します。これにより、Worker_2はDisaggregated ServingにおけるDecode Workerとして動作します。
docker run --rm -d \
  --name dynamo-decode \
  --gpus all \
  --ipc=host \
  --network host \
  -v /opt/models:/models:ro \
  -e ETCD_ENDPOINTS=http://${ETCD_IP}:2379 \
  -e DYN_SYSTEM_PORT=8081 \
  -e DYN_REQUEST_PLANE=tcp \
  -e VLLM_NIXL_SIDE_CHANNEL_PORT=20001 \
  nvcr.io/nvidia/ai-dynamo/vllm-runtime:1.4.0 \
  python3 -m dynamo.vllm \
    --model /models/Qwen3-32B \
    --served-model-name qwen3-32b \
    --discovery-backend etcd \
    --max-model-len 40960 \
    --block-size 64 \
    --disaggregation-mode decode \
    --dyn-reasoning-parser qwen3 \
    --kv-transfer-config \
      '{"kv_connector":"NixlConnector","kv_role":"kv_consumer"}'
Decode Workerでは、Prefill Workerが生成したKV Cacheを受け取って利用するため、kv_roleにkv_consumerを指定します。
なお、NixlConnectorでは従来利用されていたkv_bothが新しいvLLMで非推奨となっているため、Prefill WorkerとDecode Workerでそれぞれの役割を明示しています。KV Cache転送に利用するConnectorの種類やバージョンによって必要な設定は異なるため、実際の構築時には利用するConnectorに対応した設定を確認してください。
それではFrontendへのWorkerの登録状況を確認します。
出力結果から、Worker_1はprefill、Worker_2はWorker用途として登録されていることが確認できます。
Dynamoでは、--disaggregation-mode prefillを指定したWorkerはprefillコンポーネントとして登録されます。一方、Decode Workerはbackendコンポーネントとして登録されます。
※以下の出力では、backendと表示されているWorker_2がDecode Workerに該当します。
curl -s http://${FRONTEND_IP}:8000/health | jq
## 出力抜粋
    {
      "component": "prefill",
      "endpoint": "clear_kv_blocks",
      "namespace": "dynamo",
      "instance_id": 7587897283809643044,
      "transport": {
        "tcp": "${WORKER1_IP}:34589/694da06091a00a24/clear_kv_blocks"
      },
    {
      "component": "backend",
      "endpoint": "clear_kv_blocks",
      "namespace": "dynamo",
      "instance_id": 7587897283809643352,
      "transport": {
        "tcp": "${WORKER2_IP}:35699/694da06091a00b58/clear_kv_blocks"
      },
Disaggregated Servingの動作確認
それでは推論リクエストを送信してDisaggregated Servingの動作を確認していきます。
今回はPrefillの処理が確認しやすいように、少し長めのプロンプトを利用します。
PROMPT="日本語で回答をお願いします。
Qwen3について教えてください。
私はLLMの基本的な仕組みはある程度知っていますが、Qwen3のモデル構成については詳しくありません。
Qwen3-32Bがどのようなモデルなのか、モデルアーキテクチャやパラメータ規模、推論時の特徴などを含めて分かりやすく説明してください。
また、他のモデルと比較してどのような特徴があるのかも教えてください。"
それでは10回プロンプトを繰り返しで投げます。
for i in $(seq 1 10); do
  curl -s http://${FRONTEND_IP}:8000/v1/chat/completions \
    -H "Content-Type: application/json" \
    -d "{
      \"model\": \"qwen3-32b\",
      \"messages\": [
        {
          \"role\": \"user\",
          \"content\": \"${PROMPT}\"
        }
      ],
      \"max_tokens\": 1024
    }" | jq
done
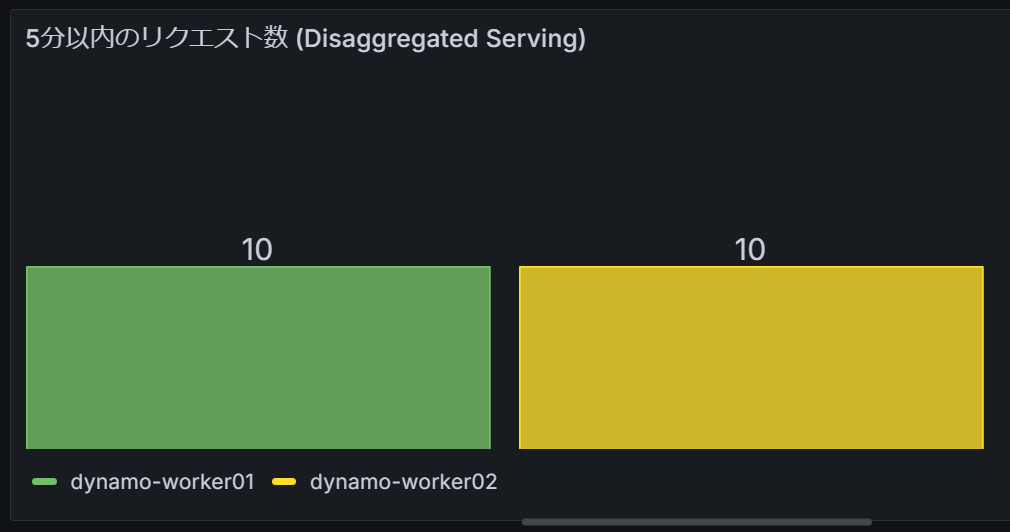
10回の推論リクエストを送信した結果、ログを確認するとWorker_1とWorker_2の両方で10回ずつリクエストが処理されていることが確認できました。
第3回の複数Worker構成では、1つのリクエストはいずれか1台のWorkerで処理されていたため、10回のリクエストがWorker_1とWorker_2へ5回ずつ振り分けられていました。
一方、今回のDisaggregated Servingでは、1つの推論リクエストに対してPrefill WorkerとDecode Workerの両方が処理に参加するため、10回のリクエストに対して両Workerで10回ずつ処理されています。
続いて、各Workerで記録されたPrefillとDecodeの処理時間を確認します。
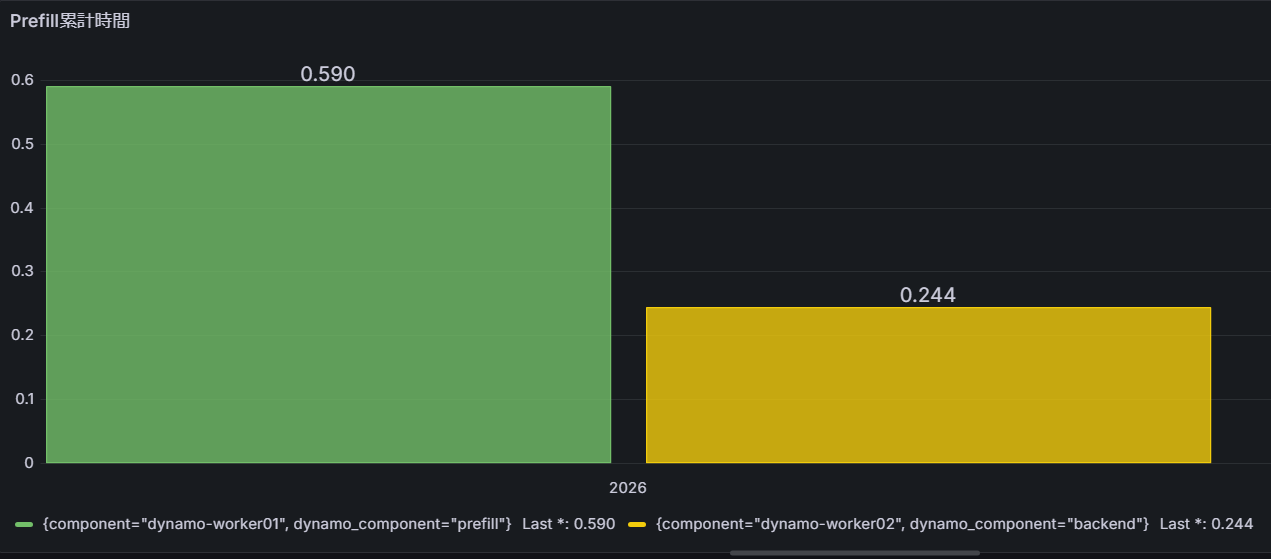
Prefillの処理時間を見ると、Prefill WorkerであるWorker_1で0.590秒、Decode WorkerであるWorker_2で0.244秒が記録されています。
Worker_1側でより多くのPrefill処理時間が記録されており、Prefill処理の中心をWorker_1が担当していることが確認できます。
なお、Decode WorkerであるWorker_2側にもPrefill処理時間が記録されています。
Disaggregated Servingでは、Prefill WorkerでPrefill処理を完了した後、その結果やKV Cache転送に必要な情報をDecode Workerへ引き渡し、Decode Worker側でKV Cacheを受け取ってからDecode処理へ移行します。
vLLMのPrefill関連メトリクスは、純粋なPrefillの計算時間だけではなく、リクエストがスケジュールされてから最初のTokenが生成されるまでの時間を対象としています。
そのため、この引き継ぎから最初のToken生成までの処理に関与するDecode Worker側でもPrefill処理時間が記録されています。
一方、Decode処理時間を確認すると、Prefill WorkerであるWorker_1では0秒、Decode WorkerであるWorker_2では199秒となっています。
Decode処理時間はWorker_2側でのみ大きく増加しており、回答となるTokenの生成をWorker_2が担当していることが明確に確認できます。
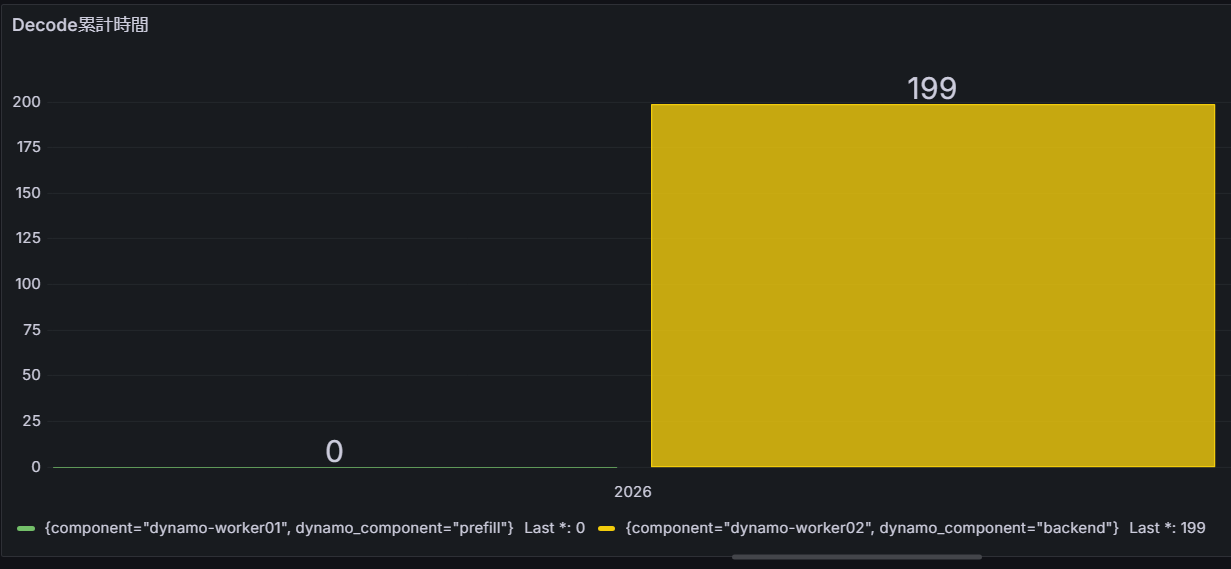
このように、Disaggregated Servingでは、1つの推論リクエストに対してPrefill WorkerとDecode Workerの両方が処理に参加し、それぞれ異なる役割を担当していることを確認できました。
※今回の検証では、Disaggregated ServingによってPrefillとDecodeが別々のWorkerで処理されていることを確認することを目的としています
そのため、リクエスト全体のend-to-end latencyやKV Cache転送時間、ネットワーク帯域による性能への影響については定量的な比較を行っていません。
実際の導入時には、通常の推論構成とDisaggregated Serving構成で、Time To First Token(TTFT)、End-to-End Latency、Throughputなどを比較することが重要です。また、Worker間でKV Cacheを転送するため、ネットワーク帯域や転送方式も性能に影響します。
まとめ
本記事では、NVIDIA DynamoのDisaggregated Servingを利用し、LLM推論のPrefillとDecodeを別々のWorkerへ分離する構成を実際に作成しました。
従来の推論構成では、1つのWorker内でPrefillとDecodeの両方を処理します。
一方、Disaggregated Servingでは、Prefill Workerがプロンプトを処理してKV Cacheを生成し、そのKV CacheをNIXLによってDecode Workerへ転送します。その後、Decode WorkerがKV Cacheを利用して回答となるトークンを生成します。
PrefillとDecodeを分離することで、それぞれの処理特性に合わせてGPUリソースを割り当てたり、Prefill WorkerとDecode Workerを独立して増減させたりできるようになります。
特に、長いプロンプトを扱う環境や、多数のリクエストを同時に処理する環境では、PrefillとDecodeの負荷を分離できる点が大きな特徴です。
一方で、KV CacheをWorker間で転送する処理が追加されるため、必ずしも全ての環境でDisaggregated Servingが有利になるわけではありません。
実際の環境では、トークン数や同時実行数、ネットワーク性能などを確認しながら、通常構成とDisaggregated Servingを使い分けることが重要です。
次回は、DynamoのKV Cache管理機能であるKVBM / KV Cache Offloadingを実際に動かしていきます。
【連載⑥】NVIDIA Dynamo 紹介:KVBM / KV Cache Offloadingを用いたKV Cacheの効率化
NVIDIAに関する情報発信はこちら
著者紹介
SB C&S株式会社
ICT事業本部 技術本部 第1技術統括部
第2技術部 1課
村上 正弥 - Seiya.Murakami -
VMware vExpert